
第 8 章定位:语义搜索与 RAG。
第 2 章已经介绍了如何把文本转换为 Embedding,第 7 章介绍了怎样把外部状态重新放回模型上下文。本章把这两条线连接起来:先找到与问题相关的资料,再让生成模型利用资料回答问题。
原文使用 Cohere、FAISS 和 LangChain 演示具体实现,下面沿用前两章的写法,重点记录检索、分块、重排序与评估的通用原理。
8.1 语义搜索与 RAG 技术全景
语义搜索(Semantic Search):利用文本的含义和上下文关系判断相关性,让系统能够找到与查询表达不同、但实际相关的内容。
例如:
用户查询:
“模型怎么记住之前聊过的内容?”

相关文档:
“Conversation Memory 的几种实现方式”
用户可能不知道文档使用的专业术语,语义搜索需要在这些不同措辞之间建立联系。
本章可以先拆成两个问题:
如何找到相关资料?
→ 检索与排序

如何根据资料回答问题?
→ 检索增强生成
原文重点介绍稠密检索、重排序和 RAG。结合辅助笔记,需要把这些概念放在各自的层级上理解:
| 概念 | 所在环节 | 主要作用 |
|---|---|---|
| 稀疏检索(Sparse Retrieval) | 检索 | 利用词项匹配等信号寻找候选资料 |
| 稠密检索(Dense Retrieval) | 检索 | 利用文本向量之间的相似度寻找候选资料 |
| 混合检索(Hybrid Search) | 检索融合 | 综合多个检索通道的结果 |
| 重排序(Reranking) | 候选排序 | 进一步判断查询与候选资料的相关性 |
| RAG | 应用流程 | 把检索结果提供给生成模型,生成回答 |
它们可以组成这样一条链路:
用户问题
↓
Sparse / Dense / Hybrid
↓
召回候选资料
↓
Reranker(可选)
↓
筛选后的资料
├→ 搜索系统:展示文档、链接或片段
└→ RAG:把资料与问题交给 LLM,生成回答
这里的召回(Retrieval)指从文档库中找出一批候选结果;后面评估中的召回率(Recall),则是衡量相关资料被找回多少的指标。
本章最重要的层级关系:
Sparse、Dense、Hybrid 描述“怎样找资料”;Reranker 描述“怎样把候选排得更准”;RAG 描述“怎样利用找到的资料生成回答”。
8.2 语言模型驱动的语义搜索实践
8.2.1 稠密检索:把搜索转化为向量比较
稠密检索(Dense Retrieval):把查询与文档分别转换为稠密向量,再根据向量相似度或距离找出相关结果。
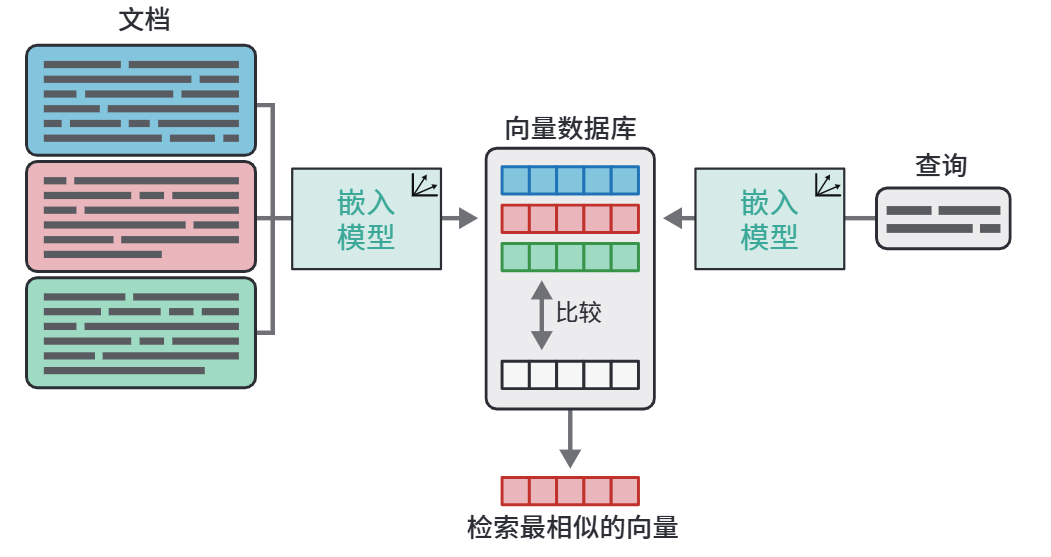
这里使用的是第 2 章介绍的句子、段落或文档级文本嵌入。一个向量通常对应一段待检索文本。
Query
↓
嵌入模型
↓
查询向量

Document / Chunk
↓
嵌入模型
↓
文档 / 文本块向量

比较向量
↓
返回最匹配的文本
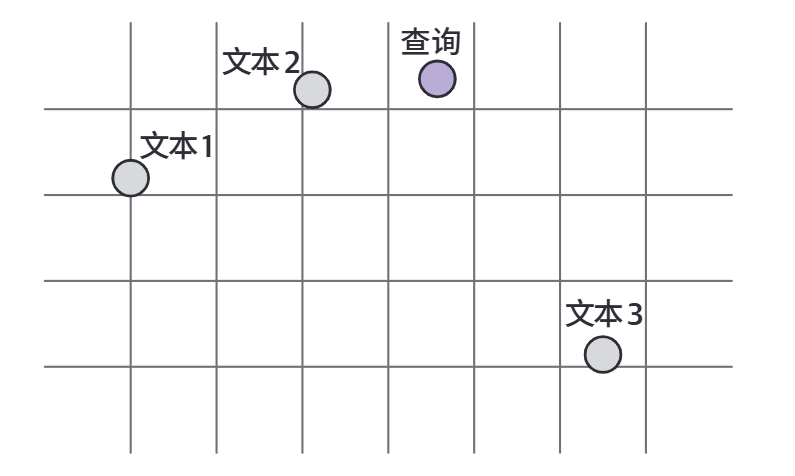
可以把图中的点理解成文本在高维空间中的位置。图中查询离文本 2 最近,因此文本 2 优先被检索出来。
补充理解:
这张二维图只是辅助理解。真实向量可能有几百或几千维,各维度共同表达模型学到的特征,并没有固定的“第 1 维表示主题、第 2 维表示情绪”这样的人工分工。
离线处理文档,在线处理查询
稠密检索的效率来自一个重要设计:文档向量可以提前计算。
准备知识库时:

文档
↓
清洗、分块
↓
生成 Embedding
↓
建立索引,保存文本与来源

收到查询时:

用户问题
↓
生成 Query Embedding
↓
搜索已有索引
↓
取回相关文本
因此每次查询时,通常只需要重新编码查询,再搜索已有向量。
文档发生变化后,相应文本块及其索引也需要更新,否则检索到的仍然可能是旧内容。
双编码器:分别编码,再比较
在稠密检索中,查询和文档不会先拼接成一段文本共同编码,而是沿两条独立的路径分别生成向量。这种结构通常称为双编码器(Bi-Encoder):
Query    → Encoder → Query Embedding ─┐
                                     ├→ 相似度 → 排序
Document → Encoder → Doc Embedding ───┘
这里的“独立编码”是指:
生成 Query Embedding 时
→ 编码器只处理当前 Query
→ 不读取候选文档中的 Token

生成 Document Embedding 时
→ 编码器只处理当前 Document
→ 不依赖某一个具体 Query
正因为文档向量不依赖某一次查询,上一节所说的“离线编码文档、在线编码查询”才得以实现。收到查询后,系统只需生成查询向量,再通过余弦相似度、点积或欧氏距离与已有文档向量比较并排序。
双编码器中的“双”,描述的是查询与文档这两条编码路径,并不意味着实现中必须存在两个参数完全不同的模型:
- 两条路径可以共享同一个编码器及其参数。
- 也可以分别使用查询编码器和文档编码器,再通过共同训练让两边的向量进入同一个可比较的表示空间。
Tips:
查询与文档向量必须处于兼容的表示空间。两个模型即使都输出 768 维向量,也不能仅凭维度相同就直接比较。
独立编码提高了检索效率,但也意味着模型不能在编码阶段逐个比较 Query 与 Document 中的 Token。因此,嵌入模型需要在训练中学会把形式不同、实际相关的查询与文档映射到相近位置:
Query:
“怎样解决连接超时?”

Document:
“连接超时的原因包括……,可以按照以下步骤处理……”
这里需要建立的是问题与相关资料之间的匹配关系。查询是在提出问题,文档是在提供答案,两边的句子形式并不相同,但向量仍应彼此接近。
所以检索模型的训练目标很重要。书中示例分别使用 search_query 和 search_document 指定输入用途,这也提醒我们:使用嵌入模型时,应遵循它对查询和文档的编码要求。
《星际穿越》的检索例子
书中把《星际穿越》英文维基百科页面的一段文本切成句子,再对这些句子生成嵌入。
查询是:
how precise was the science
→ 影片中的科学有多准确?
稠密检索优先返回了讲述天文学家赞扬影片科学准确性的句子。
单纯的词项匹配则把包含 science fiction 的电影介绍排在前面:
查询中的 science
↓
匹配到了 science fiction(科幻)
↓
但这个句子主要介绍影片类型
这个例子说明:出现相同的词,与能够回答当前问题,是两个不同的判断。
它也说明了语义检索的价值:即使查询与文档没有使用完全相同的措辞,模型仍有机会找到相关内容。
最接近的结果仍需判断是否有用
假设知识库只有电影资料,用户却问:
“月球的质量是多少?”
向量搜索仍然可以返回距离最近的几个句子,因为在现有向量中,总能找到相对更近的点。
返回 Top 3
↓
只说明它们是当前候选中最接近的 3 个
↓
还需要判断它们是否包含回答所需的信息
因此稠密检索有几个实际限制:
- 相关性不足:语料中没有答案时,最近邻结果仍可能被返回。
- 字面细节敏感:错误码、型号、ID、函数名等查询,需要保留精确的词项信息。
- 领域差异:通用模型对领域术语、缩写或特殊表达的表示可能不够好。
- 内容覆盖不足:重要信息没有被正确切分、嵌入和索引,就难以被找回。
可以通过阈值、混合检索、重排序和领域训练改善这些问题,但效果仍需用实际查询验证。
8.2.2 稀疏检索与混合检索
稀疏检索:利用词项匹配
稀疏检索(Sparse Retrieval)常见的实现包括 TF-IDF、BM25 和基于倒排索引的关键词搜索。
“稀疏”可以从词项向量来理解:
词表可能很大
↓
一篇文档只包含其中少量词项
↓
大部分位置为 0,只有少量位置有权重
以 BM25 为例,它综合考虑:
- 查询词在文档中的出现情况与频次
- 查询词在整个文档库中的普遍程度
- 文档长度对词频的影响
词频增加的收益会逐渐饱和,长度归一化则能减轻长文档仅凭包含更多词而占优势的问题。
这类方法对下面的查询经常很有用:
0x80073CF9
AuthenticationManager
某个产品型号
某个接口名称
这些查询包含明确的字面标识,需要检索系统尽量保留并利用它们。
补充理解:
本节主要讨论 BM25 等传统词项检索。一些通过模型学习的稀疏检索也能利用语义信息。另外,错误码和函数名能否被完整匹配,还取决于分词方式和索引字段配置。
Sparse 与 Dense 的取舍
| 维度 | 传统稀疏检索 | 稠密检索 |
|---|---|---|
| 主要信号 | 词项匹配与权重 | 学到的向量表示与相似度 |
| 常见优势 | 精确词项、实体、编号、错误码 | 同义表达、自然语言描述、概念匹配 |
| 常见短板 | 不同措辞可能缺少直接匹配 | 可能弱化关键字面差异 |
| 准备工作 | 分词与建立词项索引 | 编码文本与建立向量索引 |
| 质量影响因素 | 分词、字段、词项统计 | 模型、训练任务、文本分块、距离度量 |
可以先用一句直觉记忆:
Sparse
→ 优先利用“出现了哪些词”

Dense
→ 优先利用“表达了什么含义”
这只是两类方法的侧重点,实际效果需要在具体数据上比较。
混合检索:融合多个检索信号
混合检索(Hybrid Search)最常见的形式是结合稀疏检索与稠密检索。
例如:
“0x80073CF9 安装失败怎么解决?”

0x80073CF9
→ 用词项检索寻找明确错误码

安装失败怎么解决
→ 用语义检索寻找相关解释和处理方法
一个常见流程是:
同一个 Query
├→ BM25 → 一批候选
└→ Dense → 一批候选
             ↓
        去重与结果融合
             ↓
        合并后的候选集合
             ↓
        Reranker(可选)
这里还需要解决一个具体问题:不同通道的分数通常不在同一个尺度上。
BM25 分数:12.6
余弦相似度:0.82

这两个数不能直接用大小判断哪篇文档更相关。
融合时可以对分数进行适当归一化和加权,也可以使用倒数排名融合(Reciprocal Rank Fusion,RRF),根据文档在各个结果列表中的排名计算融合分数。后者利用排名,避免直接比较不同来源的原始分数。参见 Elasticsearch 的 RRF 说明。
Tips:
元数据过滤、结构化查询和重排序也可以加入这条流程,但它们承担不同职责。例如“只查某个产品的文档”是在限定范围,“对候选重新打分”是在改善排序;混合检索的核心则是融合多个检索信号。
8.2.3 长文本分块:决定系统能够检索到什么
文本分块(Chunking):把文档切成适合编码和检索的较小单元,每个单元称为一个 Chunk。
分块至少解决两个问题:
输入长度
→ 嵌入模型一次能处理的 Token 数有限

表示粒度
→ 一个向量很难同时突出长文档中的所有具体细节
即使某个嵌入模型能够处理长文本,用单个向量概括多主题文档,也可能使其中的小细节在表示中被弱化。
一篇文档用一个向量,还是多个向量?

| 方案 | 做法 | 主要取舍 |
|---|---|---|
| 只嵌入标题或开头 | 用代表性部分生成文档向量 | 简单,但未覆盖部分中的信息可能难以检索 |
| 聚合多个块向量 | 先分块,再对向量取平均等 | 得到整体表示,但具体细节可能被弱化 |
| 分别保存块向量 | 每个 Chunk 都有自己的向量 | 能定位具体片段,但需要管理更多索引项和来源关系 |
在需要搜索文档内部细节时,按块保存向量通常更合适:
一篇文档
├→ 安装步骤 → 向量 1
├→ 配置说明 → 向量 2
└→ 故障排查 → 向量 3

用户问配置问题
↓
优先找到配置片段
图中的“单文档多向量”是指为不同文本块分别保存向量。这里每个块仍然可以使用一个普通文本向量表示。
按什么单位切分?

| 分块方式 | 优势 | 需要注意的地方 |
|---|---|---|
| 固定字符数 | 容易实现 | 字符数与 Token 数不一致,可能切断词或句子 |
| 固定 Token 数 | 便于控制模型输入长度 | 可能切断一个完整的语义单元 |
| 按句子 | 单元清晰、定位细 | 单句可能缺少必要上下文 |
| 按段落 | 更容易保留完整论述 | 段落长度不固定,仍需处理超长段落 |
| 按标题、章节等结构 | 保留文档组织关系 | 需要正确识别原文结构 |
| 重叠窗口 | 让相邻块共享部分上下文 | 增加索引量,并可能返回重复内容 |
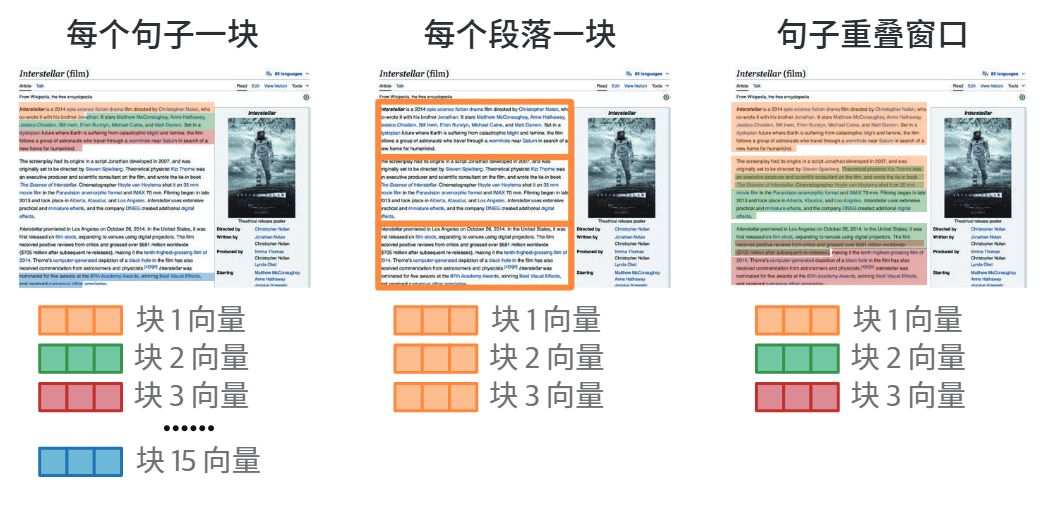
书中建议,较长段落可以尝试每 3~8 个句子划为一块。这是帮助选择初始粒度的例子,实际大小还要结合文本类型、查询特点和模型限制调整。
块太小与块太大的问题
块太小:
“它在重启后恢复正常。”
→ 缺少“它”指什么、发生了什么故障

块太大:
把安装、配置、故障排查全放在一起
→ 具体问题的相关信息可能被大量内容稀释
理想的 Chunk 应尽量保留一个可以独立理解、足以回答某类问题的语义单元。
重叠分块怎样保留上下文?
假设每块包含 5 个 Token,相邻块重叠 1 个 Token:
原文:
A B C D E F G H I

Chunk 1:
A B C D E

Chunk 2:
        E F G H I
        ↑
      重叠部分
被切分位置附近的内容同时出现在相邻块中,可以缓解重要关系恰好被边界切断的问题。
但重叠部分越多,索引与嵌入成本也越高,而且检索前几名可能被相似片段占满。组装 RAG 上下文时,需要考虑合并相邻片段或去除重复信息。
给文本块保留标题与来源
有些片段依赖文档主题才能理解。可以在编码和展示时附加必要的上下文:
文档标题:数据库连接故障排查
章节标题:连接超时
正文:……
同时保存与原文对应的元数据,例如:
doc_id / chunk_id
文档标题、章节标题
原文路径或 URL
页码或段落位置
版本、更新时间
这些信息可以用于检索过滤、找回相邻内容、更新索引和生成出处。
一句话总结:
分块决定了“什么内容作为一个单元被表示和找回”。模型再强,也需要先有覆盖正确、上下文足够的检索单元。
8.2.4 最近邻搜索与向量数据库
拿到查询向量后,需要找出与它最匹配的文档向量。
相似度与距离
常见度量包括:
| 度量 | 排序方向 | 直觉 |
|---|---|---|
| 余弦相似度(Cosine Similarity) | 越大越相似 | 比较两个向量的方向 |
| 点积(Dot Product) | 越大越匹配 | 同时受到方向和向量长度影响 |
| 欧氏距离(L2 Distance) | 越小越接近 | 比较两个点之间的距离 |
余弦相似度的公式是:
其中,q 是查询向量,d 是文档向量。
如果两边都经过单位长度归一化,则点积与余弦相似度相同,平方欧氏距离也与它们有明确关系:
因此,在这个条件下,按点积从大到小排序,与按 L2 距离从小到大排序等价。
Tips:
距离度量和归一化方式应与嵌入模型的使用要求一致。相似度分数也不能直接解释成“答案正确的概率”。
精确最近邻与近似最近邻
最直接的方法是遍历全部向量:
Query Vector
↓
与每个文档向量计算距离
↓
排序
↓
返回 Top-K
这是精确最近邻搜索。数据量较小时,实现简单,也适合建立检索基线。
向量规模增长后,可以使用近似最近邻(Approximate Nearest Neighbor,ANN):
利用索引结构缩小搜索范围
↓
减少需要比较的向量
↓
用一定的近邻召回损失换取更低延迟
这里需要分别验证:
- 向量搜索是否找到了真正的近邻:受索引与搜索参数影响。
- 这些近邻是否与问题相关:受嵌入模型、文本内容和任务影响。
精确地找到了最近的向量,也可能得到与问题无关的文本。
书中的 FAISS 索引
原文使用:
import faiss
import numpy as np

index = faiss.IndexFlatL2(embeds.shape[1])
index.add(np.float32(embeds))
distances, ids = index.search(np.float32([query_embed]), 3)
这里 embeds 是已生成的文档向量矩阵,query_embed 是一个查询向量。检索得到的 ids 用来查回对应原文,distances 用来描述距离。
两个容易混淆的细节:
IndexFlatL2采用遍历向量的精确搜索,使用 FAISS 并不意味着一定使用 ANN。- FAISS 的 L2 度量返回的是平方欧氏距离,数值越小,向量越接近。
这两点可以分别参考 FAISS 索引类型与距离度量说明。
向量索引与向量数据库
| 层次 | 主要职责 |
|---|---|
| 向量搜索库 / 索引 | 存储和搜索向量,优化近邻检索 |
| 向量数据库 | 在向量检索基础上提供数据管理、元数据过滤、持久化和服务能力等 |
FAISS 可以承担本地向量索引;完整应用还需要管理文本、来源、更新和权限等信息。向量数据库往往把其中一部分能力一起提供,具体范围取决于产品和索引实现。
无论采用哪种方式,都需要保留:
向量 ID
↓
原始 Chunk
↓
所属文档与来源
生成模型最终需要利用的,是这些向量对应的文本内容。
8.2.5 面向检索的嵌入模型微调
第 2 章已经提到:训练任务决定向量更倾向于表达什么关系。
在检索中,我们希望:
相关 Query 与 Document
→ 更接近

不相关 Query 与 Document
→ 更远离
书中使用一条首映信息作为目标文档:
Interstellar premiered on October 26, 2014, in Los Angeles.
对应的查询可以分为:
| 查询 | 与该文档的关系 |
|---|---|
| Interstellar release date | 相关:查询上映日期 |
| When did Interstellar premiere | 相关:查询首映时间 |
| Interstellar cast | 不相关:查询演员阵容 |
这三条查询都在谈《星际穿越》,所以一个只较好识别主题的模型,可能把它们都放在目标文档附近:

经过查询与文档相关性训练后,理想效果是:

都提到了同一部电影
↓
继续区分用户究竟在问什么
↓
首映日期的查询靠近日期文档
演员阵容的查询远离日期文档
因此,检索微调需要查询、相关文档以及合适的负例。主题接近、但无法回答问题的文档尤其有助于模型学习细粒度区别。
补充理解:
这里训练的是嵌入模型的检索表示能力。后面的 RAG 则是在运行时把检索结果加入生成模型的上下文,这两个环节可以分别设计。替换或微调嵌入模型后,通常需要重新生成知识库向量,保证查询与文档仍处于同一套兼容的表示空间。具体训练方法会在第 10 章继续展开。
8.2.6 重排序与交叉编码器
重排序(Reranking):接收查询与已有候选结果,重新判断相关性,再调整结果顺序。
一个常见的两阶段设计是:
大规模文档库
↓
Retriever
快速找出一批候选,例如 Top 50
↓
Reranker
对候选精细打分
↓
保留排序靠前的结果,例如 Top 5
这里的 50 和 5 只是流程示例,实际数量需要结合召回质量、延迟和后续上下文预算选择。
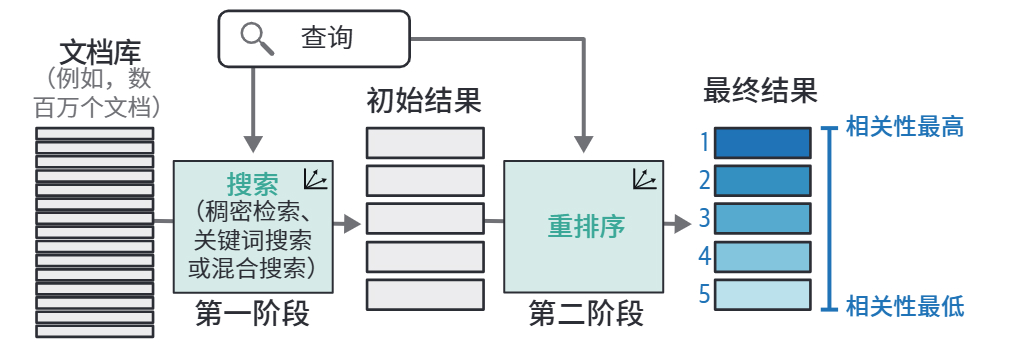
第一阶段要兼顾速度与覆盖范围;第二阶段可以在较小集合中进行更复杂的相关性判断。
交叉编码器:把 Query 与 Document 一起理解
交叉编码器(Cross-Encoder)把查询与候选文档共同输入模型,直接输出相关性分数。
经典 BERT 类交叉编码器的输入形式可以写成:
[CLS] Query [SEP] Document [SEP]
↓
Query 与 Document 的 Token 在编码时交互
↓
分类 / 评分头
↓
相关性分数
这也对应了第 2 章介绍的 [CLS] 与 [SEP]:一个用于提取整体表示,一个用于分隔输入文本。
相比先独立压缩成两个向量再比较,联合编码让模型有机会直接分析:
查询中的具体要求
↔
文档中的具体说明
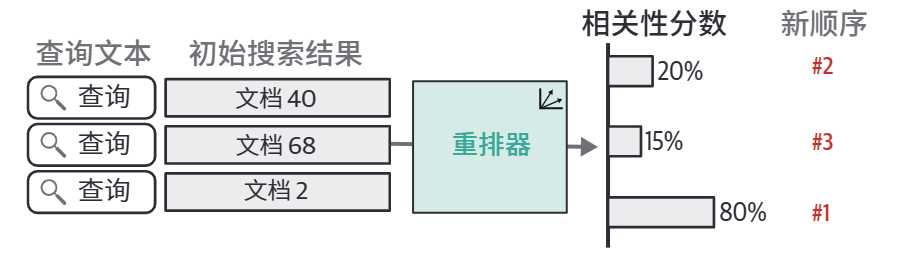
书中这种逐对打分的流程是:
(Query, Document A) → Score A
(Query, Document B) → Score B
(Query, Document C) → Score C
                         ↓
                    按分数重排
批量处理可以同时计算多组文本对;每一组仍是在判断当前查询与某个文档的关系。
Bi-Encoder 与 Cross-Encoder 的区别
| 维度 | Bi-Encoder | Cross-Encoder |
|---|---|---|
| 输入方式 | 查询与文档分别编码 | 查询与文档联合编码 |
| 交互发生在哪里 | 编码后比较向量 | 模型内部进行文本交互 |
| 文档结果能否提前复用 | 可以预计算文档向量 | 每次需结合当前查询重新评分 |
| 常见用途 | 大规模向量召回 | 较小候选集合的精排 |
| 主要取舍 | 高效,但细粒度匹配受向量表示限制 | 匹配更细,但逐对计算成本较高 |
双编码器适合从大量文档中快速筛选;交叉编码器适合进一步判断少量候选。这种组合可以参考 Sentence Transformers 的 Retrieve & Re-Rank 文档。
补充理解:
Cross-Encoder 描述的是联合编码方式。经典实现常使用 BERT 类表示模型,也可以使用其他模型;Reranker 则描述它在检索流程中的作用。生成式模型也可以用于评分或生成排序,因此这些名称需要分别理解。
相关性分数应该怎样解读?
原图用百分比示意不同文档的相关程度。实际重排模型可能返回原始分数,也可能通过 Sigmoid 等函数映射到 0~1。
例如,Sentence Transformers 的部分 MS MARCO 模型默认可以输出原始分数,使用 Sigmoid 后才得到 0~1 的结果,参见官方模型说明。
因此需要区分:
分数较高
→ 当前模型认为它相对更相关

分数为 0.8
→ 具体含义取决于模型与评分方式
即使分数位于 0~1,也需要经过校准和验证,才能把它当作某种可靠概率解释。
重排器的能力受候选集合限制
正确文档没有进入 Top 50
↓
Reranker 只能看到这 50 个候选
↓
无法把未输入的正确文档排到前面
所以需要同时关注:
- 第一阶段是否覆盖了回答所需的资料
- 第二阶段是否把这些资料放在更靠前的位置
重排器可以接在稀疏、稠密或混合检索之后,也可以用于 RAG,在有限的生成上下文中优先保留更有用的资料。
8.2.7 检索评估:资料找对了多少,排序是否合理?
检索系统需要用一组固定查询进行比较。只展示几个效果好的例子,很难判断系统整体是否可靠。
一套基本的评估资料包括:
文档库
+
查询集合
+
查询与文档的相关性标注
相关性标注说明:对于某个查询,哪些文档相关、相关到什么程度。
.jpg)
如果实际检索单位是 Chunk,评估时也需要明确是在按文本块还是整篇文档计算,避免把同一文档的重复片段混成多个独立命中。
Precision@K 与 Recall@K
前 K 项精确率(Precision@K):
它回答:
已经返回的前 K 个结果,有多少是相关的?
前 K 项召回率(Recall@K):
它回答:
应该找回的相关结果,有多少进入了前 K 个?
例如,一个查询共有 4 个相关文档,系统前 5 个结果命中其中 3 个:
Precision@5 = 3 / 5 = 0.6
Recall@5    = 3 / 4 = 0.75
提高返回数量可能找回更多相关资料,也可能带入更多无关资料。因此,K 本身也是评估口径的一部分。
为什么只看命中数量还不够?
假设某个查询只有一个相关文档:
系统 A:
相关、不相关、不相关

系统 B:
不相关、不相关、相关
两者的 Precision@3 都是 1/3,但系统 A 把有用结果放在第 1 位,用户可以更快找到。

因此需要对排序位置敏感的指标。
AP:在每个相关结果的位置计算精确率
平均精确率(Average Precision,AP)的计算思路是:
从前往后查看结果
↓
每遇到一个相关结果
↓
记录截至当前位置的 Precision
↓
把这些值相加
↓
除以该查询的相关文档总数
先看只有一个相关文档的情况:
相关文档在第 1 位:
AP = 1 / 1 = 1

相关文档在第 3 位:
AP = 1 / 3 ≈ 0.333
接着看书中有两个相关文档的例子:
| 位置 | 是否相关 | 截至当前位置的相关结果数 | Precision |
|---|---|---|---|
| 1 | 是 | 1 | 1 / 1 = 1 |
| 2 | 否 | 1 | 1 / 2 = 0.5 |
| 3 | 是 | 2 | 2 / 3 ≈ 0.667 |
只在相关结果出现的位置取精确率:

位置 2 的精确率不直接加入分子,但这个不相关结果占据了排名位置,因此会降低后面相关结果的精确率。
将计算过程写成公式:
其中:
- R_q:该查询在评估标注中的相关文档总数。
- N:当前评估的返回结果数量。
- \operatorname{rel}_i:第 i 个结果相关时为 1,不相关时为 0。
重要细节:
分母包含该查询所有已标注的相关文档,漏检的相关文档也包含在内。例如共有 3 个相关文档,只在第 1、3 位找回其中两个,另一个完全没有找回,则:
\operatorname{AP} = \frac{1+\frac{2}{3}+0}{3} \approx 0.556这样才能同时反映“是否找全”和“是否排在前面”。计算口径可以参考《信息检索导论》的检索评估章节。
如果只评估前 K 项,可以将求和范围截断到 K。对于 AP@K,不同评估实现可能采用不同分母约定,比较结果时需要确认口径。没有相关文档的查询,也需要单独规定如何计分。
MAP:对多个查询的 AP 再取平均
均值平均精确率(Mean Average Precision,MAP,也写作 mAP):
这里 Q 是评估查询集合,|Q| 是查询数量。
沿用书中的三个例子:
查询 1:AP = 1
查询 2:AP = 1/3
查询 3:AP = 5/6

MAP = (1 + 1/3 + 5/6) / 3
    ≈ 0.722

原图对部分结果做了一位小数近似,因此显示为 0.3、0.8 和 0.7;这里保留更多精度,便于核对计算。
可以记成:
AP
→ 单个查询的相关结果覆盖与排序质量

MAP
→ 多个查询的 AP 均值
nDCG:允许相关程度有等级
AP 通常使用二元标注:
相关 / 不相关
但文档有时可以分成多个等级:
3 → 高度相关,直接提供关键答案
2 → 比较相关
1 → 有一定帮助
0 → 不相关
归一化折损累积增益(Normalized Discounted Cumulative Gain,nDCG)同时考虑:
相关程度
+
排序位置
+
相对于理想排序的表现
它的名字可以逐步拆开。
Gain:相关结果带来的收益。
一种常见定义是:
因此相关性等级 0、1、2、3 分别对应收益 0、1、3、7。
Discounted:越靠后的结果,收益越打折。
第 i 位使用 \log_2(i+1) 作为折损分母,得到:
第 1 位的分母为 1,第 2 位约为 1.585,第 3 位为 2。高度相关文档越靠后,对得分的贡献越低。
Normalized:除以同一查询的理想排序得分。
将该查询已标注的文档按相关等级从高到低排列,取前 K 项,用同样的公式计算,就得到 IDCG@K:
例如,一个查询有三个文档,相关等级分别为 3、2、0:
理想排序:
[3, 2, 0]

IDCG@3 = 7/1 + 3/log₂(3) + 0/2
       ≈ 8.893

实际排序:
[2, 0, 3]

DCG@3 = 3/1 + 0/log₂(3) + 7/2
      = 6.5

nDCG@3 = 6.5 / 8.893
       ≈ 0.731
这个分数表示:当前排序取得的 DCG 约为理想排序的 73.1%。
为什么需要归一化?
不同查询的相关文档数量与相关等级可能不同:
查询 A:
有多个高度相关文档
→ 理想 DCG 较高

查询 B:
只有少量相关文档
→ 理想 DCG 较低
直接比较它们的 DCG,会受到各自可用相关文档的影响。
除以各自的理想 DCG 后,可以把它们放到相同的相对尺度,再对多个查询求平均。这里的归一化是在调整评估得分尺度。
Tips:
nDCG 的增益函数存在不同约定,评估时需要明确相关等级、增益函数、K 值,以及 IDCG 为 0 时如何处理。本文使用《信息检索导论》中常见的指数增益形式。
在两阶段检索中,可以分别观察:
第一阶段候选召回
→ 例如 Recall@50:需要的资料是否进入候选?

第二阶段精排
→ 例如 nDCG@5:有用资料是否排在前面?
这些指标用于定位问题。最终是否改善了用户得到的答案,还需要继续评估 RAG 的生成结果。
8.3 RAG:用检索资料增强生成
检索增强生成(Retrieval-Augmented Generation,RAG):先检索外部信息,把相关信息加入模型当前的输入,再由生成模型回答问题。

可以逐词理解:
Retrieval
→ 找到相关资料

Augmented
→ 用资料补充当前上下文

Generation
→ 根据问题与上下文生成回答
在本章讨论的常见应用流程中,生成模型的权重保持不变。更新知识库并刷新索引后,新的外部资料就有机会被检索并用于后续回答。
这也对应第 7 章的检索式记忆:
外部保存信息
↓
按当前需要取回
↓
重新放进 Context
↓
模型才能利用
补充理解:
RAG 可以为回答提供外部依据,降低仅凭模型内部知识生成错误内容的风险。最终效果仍然取决于资料本身、检索结果、上下文组织和生成模型对资料的使用。
8.3.1 从普通搜索到 RAG
普通检索系统的输出通常是:
问题
↓
检索、排序
↓
文档列表 / 链接 / 原文片段
用户继续阅读这些资料,并自行组合答案。
RAG 在这里接上生成步骤:
问题
↓
检索、排序
↓
相关资料
↓
问题 + 资料 → LLM
↓
综合后的回答

检索来源可以包括:
关键词搜索
向量搜索
混合搜索
数据库查询
搜索引擎
文档系统或业务 API
向量数据库是常见基础设施;RAG 的定义关注的是检索信息如何参与生成。
同样,下面两种流程都可以构成 RAG:
Retriever → 相关资料 → LLM

Hybrid Retriever → Reranker → 相关资料 → LLM
重排器是可选的增强组件。来源引用也不是 RAG 定义的必需条件,但能让用户检查依据,实际应用中很有价值。
8.3.2 一个完整流程:从知识库到回答
知识库准备
原始资料
↓
解析、清洗
↓
保留文档结构并分块
↓
生成块向量 / 建立词项索引
↓
保存原文与元数据
↓
可检索的知识库
准备过程需要保持文本、索引和来源之间的对应关系。文档有新版本时,也需要同步更新相应检索内容。
查询与生成
用户问题
↓
必要的对话上下文
↓
查询改写 / 拆分(可选)
↓
检索与范围过滤
↓
候选 Chunks
↓
重排序(可选)
↓
去重、补充标题或相邻片段
↓
按 Token 预算组装 Context
↓
问题 + Context → 生成模型
↓
回答与来源

嵌入模型与生成模型分别负责什么?
一个向量检索 RAG 常包含两类模型,加入重排序后还可能有第三类:
| 模型 | 输入 | 输出 | 主要任务 |
|---|---|---|---|
| 嵌入模型 | 查询、文本块 | 文本向量 | 让相关资料容易被检索 |
| 重排模型(可选) | 查询与候选资料 | 分数或排序结果 | 改善候选相关性排序 |
| 生成模型 | 问题、指令与检索资料 | 自然语言或结构化回答 | 提取、综合和组织答案 |
嵌入模型与生成模型可以来自不同模型系列。需要保持兼容的,是检索阶段使用的查询向量与文档向量。
另外,两个模型的上下文限制也要分别检查:
嵌入模型
→ 一个 Chunk 能否完整编码?

生成模型
→ 问题、历史、指令、检索资料和输出
  是否都能放进当前上下文预算?
上下文数量需要按问题选择
检索到很多资料后,还要决定哪些资料真正进入 Prompt。
过少
→ 可能遗漏关键证据,无法回答完整问题

过多
→ 占用 Token,增加延迟,并引入无关或重复信息
因此,上下文组装需要考虑:
- 是否覆盖问题的各个部分
- 是否有完整的句子、标题和必要前提
- 是否存在重复片段
- 是否混入不同版本或互相冲突的内容
- 是否还能给模型输出保留足够空间
这一步连接了检索结果与生成模型,值得作为独立组件处理。
书中的云端与本地示例
| 示例 | 实现方式 | 共同流程 |
|---|---|---|
| 云端 | 使用 Cohere 的嵌入、搜索与聊天接口 | 检索文本 → 提供问题与资料 → 生成回答 |
| 本地 | 使用嵌入模型、FAISS 和量化生成模型,再用 LangChain 编排 | 建立索引 → 取回文本 → 填入提示词 → 本地生成 |
书中云端示例通过接口返回引用信息,本地示例主要展示正文生成。引用能力还可以由应用实现:保留来源编号,并检查回答中的引用是否对应实际检索片段。
框架负责连接这些步骤,检索与生成的基本关系保持一致。
8.3.3 RAG 提示词与来源引用
RAG 提示词至少要提供:
当前问题
+
相关资料
+
使用资料的规则与回答格式
一个简化模板可以写成:
任务:
根据下面的资料回答用户问题。

要求:
1. 只根据资料陈述事实。
2. 资料不足时,明确说明不足之处。
3. 在资料支持的事实后标注来源编号。
4. 保持回答简洁,直接回应问题。

资料:
<sources>
[1] 标题:{title_1}
    内容:{chunk_1}
[2] 标题:{title_2}
    内容:{chunk_2}
</sources>

问题:
{question}
应用再把来源编号映射回原文、页面或文档位置。
Tips:
这些规则属于第 6 章讨论的提示词约束。是否忠实使用资料、是否遗漏前提、引用是否正确,还需要核对输出与原文的对应关系。
沿用书中的票房例子
书中的实验语料记载:
[1] 全球票房超过 6.77 亿美元;
    计入后续重映后累计为 7.73 亿美元。
用户问:
Income generated
→ 影片产生了多少收入?
根据这份资料,回答应保留两个数字各自的统计口径:
资料记载,《星际穿越》的全球票房超过 6.77 亿美元;
计入后续重映后,累计票房为 7.73 亿美元。[1]
这里还需要保留资料使用的概念——票房收入。只有票房资料时,无法据此推出影片的净利润。
这个例子中,生成模型的主要工作是从原文提取信息、保留条件,再把简短查询组织成完整答案。
引用也需要对应到具体论断
一个来源链接只能说明“引用了这份资料”。还需要继续核对:
回答中的具体事实
↓
对应哪一段原文?
↓
原文是否支持这个事实及其条件?
例如,一份文档只写了票房收入,回答却给出制作成本或净利润,那么引用该文档也不能支持这些新增数字。
因此,来源可追溯与论断有证据支持,需要同时检查。检索资料也应作为待处理数据进入上下文,继续遵守第 7 章介绍的指令与外部内容边界。
8.3.4 高级 RAG:改善查询与检索流程
基础 RAG 可以直接使用用户问题检索。但在多轮对话、复杂比较或多个数据源的场景中,原始问题未必适合直接交给检索器。
原文介绍了几类扩展:
查询改写
查询改写(Query Rewriting):结合必要上下文,把用户表达改写成更清楚、适合检索的查询。
例如:
上一轮:
“我们继续讨论《星际穿越》。”

当前问题:
“它的科学依据靠谱吗?”

改写后的查询:
“《星际穿越》的科学准确性与科学顾问”
这里既补全了“它”所指的对象,也把口语表达转成检索目标。
书中关于海豚作文的例子同样如此:从一段包含企鹅、海豚和作业安排的聊天内容中,提取真正需要查询的“海豚生活在哪里”。
改写时需要保留原始意图、关键实体和条件。用户指定的型号、年份或错误码,也应继续保留。
多查询 RAG
多查询 RAG(Multi-Query RAG):从一个问题生成多个查询,分别检索后融合结果。
它可以有两种常见用途:
同一个需求,换几种措辞检索
→ 增加找到相关资料的机会

复杂问题,拆成多个子问题检索
→ 覆盖不同部分需要的资料
书中用财报比较说明第二种情况:
问题:
“比较 NVIDIA 2020 年与 2023 年的财报。”

查询 1:
“NVIDIA 2020 年财报”

查询 2:
“NVIDIA 2023 年财报”
两次检索可以分别执行,结果再去重、筛选并交给生成模型。比较回答还需要对齐指标、时间范围等口径,这些条件应保留在原始问题和生成指令中。
多跳 RAG
多跳 RAG(Multi-Hop RAG):后续查询依赖前一次检索得到的信息。
例如书中的汽车制造商问题,可以先明确排名标准,再分步处理:
第 1 步:
检索某一年、按指定标准排名靠前的汽车制造商
↓
得到具体公司名称
↓
第 2 步:
针对这些公司分别检索是否生产电动汽车
↓
汇总各公司的资料与结论
两者的主要区别是查询之间的依赖:
| 方式 | 查询怎样产生 | 执行关系 |
|---|---|---|
| 多查询 | 可以直接从原始问题生成多条查询 | 通常可以独立或并行执行 |
| 多跳 | 后续查询由前一步结果派生 | 存在前后依赖 |
多跳流程需要检查每一步的中间结果。第一步识别错对象,后续检索就可能围绕错误对象继续展开。
查询路由
查询路由(Query Routing):根据问题选择合适的数据源或检索方式。
人力资源问题
→ 公司制度知识库

客户记录问题
→ CRM

需要某个精确字段
→ 结构化数据库查询

需要某段技术说明
→ 文档检索
它首先决定“去哪里找”,随后才在选定范围内检索。路由还需要遵守当前用户能够访问哪些资料的限制。
智能体 RAG
智能体 RAG(Agentic RAG):由模型根据当前问题和检索观察,动态决定接下来的检索动作。
用户问题
↓
选择数据源与查询
↓
检索
↓
读取结果,判断资料是否足够
├→ 足够:整理回答
└→ 不足:改写查询、换数据源或继续检索
这与第 7 章的工具调用和智能体相接:
检索器 / 数据源
→ 可以作为工具

LLM
→ 根据结果提出下一步动作

宿主程序
→ 校验、执行并限制调用
多查询、多跳都可以由预先设计好的流程实现。引入智能体后,才把更多路径选择交给模型在运行时决定。
因此仍然可以沿用第 7 章的原则:先使用足以完成任务的固定流程,需要动态选择时再增加自主控制,并保留明确的停止条件和调用预算。
这几种扩展分别解决什么?
- 查询改写:让检索器更清楚用户在问什么。
- 多查询:用多个查询补充表达或覆盖多个子问题。
- 多跳:利用前一步结果继续查找后续证据。
- 查询路由:选择正确的数据源与检索通道。
- 智能体 RAG:动态决定是否继续查,以及下一步怎样查。
8.3.5 RAG 效果评估
检索指标回答“资料有没有找对、排好”;RAG 还要继续检查模型是否正确使用资料并回答了问题。
可以分成三层:
检索层
→ 是否找到足够相关的证据?

生成层
→ 是否依据证据回答了问题?

引用层
→ 具体论断是否有可以核对的来源支持?
生成与引用的几个评估维度
| 维度 | 主要检查什么 |
|---|---|
| 流畅性(Fluency) | 语言是否顺畅,表达与逻辑是否连贯 |
| 感知效用(Perceived Utility) | 用户是否觉得回答有用、能够帮助完成任务 |
| 引用召回率(Citation Recall) | 需要引用支持的事实陈述中,有多少获得完整的来源支持 |
| 引用精确率(Citation Precision) | 给出的引用中,有多少有效支持对应论断 |
| 忠实度(Faithfulness) | 答案中的陈述是否得到所提供上下文的支持 |
| 答案相关性(Answer Relevance) | 回答是否回应用户的问题,是否遗漏重点或偏离主题 |
其中前四个维度来自书中引用的论文《Evaluating Verifiability in Generative Search Engines》。书中还通过 Ragas 介绍了忠实度与答案相关性等评估思路。
引用召回率与引用精确率
可以先分别理解为:
引用召回率:
需要证据支持的事实陈述中,
有多少得到完整引证支持?

引用精确率:
已经提供的引用中,
有多少真正支持其对应论断?
例如:
回答有 5 条需要引用支持的事实,
其中 3 条得到完整支持。
→ 按这个计数口径,引用召回率为 3/5。

给出了 4 个引用,
其中 3 个支持对应论断。
→ 按这个计数口径,引用精确率为 3/4。
具体评估还需要规定事实怎样拆分、多个引文怎样联合支持一句话等规则。
这与检索召回率对应不同对象:
检索 Recall
→ 检查相关文档 / 文本块是否被找回

Citation Recall
→ 检查回答中的事实是否获得完整引证支持
忠实度与事实正确性
忠实度主要检查答案是否能由给定资料支持。
但还需要检查资料本身:
资料正确、当前有效
↓
回答忠实使用资料
↓
更有机会得到正确答案

资料已经过期或存在错误
↓
模型忠实复述
↓
回答仍可能不符合实际情况
因此评估事实可靠性时,还要关注来源、更新时间、适用条件和统计口径。
另外,回答可能忠实于上下文,却没有回答问题。例如用户问上映时间,模型只介绍了演员,陈述有依据,但答案相关性仍然不足。
人工评估与 LLM-as-a-Judge
可以让另一个模型根据问题、检索上下文和生成答案进行评分,这就是LLM-as-a-Judge。
问题
+
检索上下文
+
生成答案
+
明确的评分规则
↓
评审模型
↓
各维度的评分与判断依据
它适合辅助批量比较,但评审模型的判断本身也需要验证。沿用第 6 章的原则,可以固定评审提示词与评分标准,再用人工标注样本抽查一致性。
用于系统改动的测试集,应覆盖不同情况:
- 可以由单个片段直接回答的问题
- 需要组合多个片段的问题
- 包含精确编号、实体或领域术语的问题
- 依赖上一轮对话的问题
- 知识库中没有足够资料的问题
- 涉及不同版本或相互冲突资料的问题
还应同时记录响应延迟、Token 使用量和调用成本,确认质量提升的实际代价。
排错时沿数据流逐步检查
RAG 是一条多阶段链路,错误可能发生在不同位置:
| 观察到的问题 | 优先检查的环节 |
|---|---|
| 正确内容根本无法检索 | 文档是否成功解析、分块和建立索引 |
| 总返回同主题但不回答问题的资料 | 查询表达、嵌入模型、词项检索与融合策略 |
| 正确片段在候选中,却没有进入最终上下文 | 重排序、筛选阈值、去重与 Token 预算 |
| 上下文有完整答案,生成时却遗漏或混淆 | 提示词、模型能力、上下文组织与输出校验 |
| 回答给出了来源,但来源无法支持具体事实 | 论断与引文的对应关系 |
| 答案忠实于资料,但实际信息过时 | 数据源版本、更新流程与索引刷新 |
按这条顺序查看中间结果,更容易定位应该修改哪个组件。
一句话总结:
RAG 评估需要同时检查“找到了什么、模型怎样使用、答案依据在哪里”,并把质量与成本放在一起比较。
8.4 第 8 章总结
本章的主要概念可以整理为:
| 概念 | 核心理解 |
|---|---|
| Sparse Retrieval | 利用词项匹配等信号检索 |
| Dense Retrieval | 分别编码查询和文本,通过向量比较检索 |
| Hybrid Search | 融合多个检索通道的结果 |
| Chunking | 确定哪些内容作为独立单元被表示和找回 |
| 向量索引 / 向量数据库 | 搜索与管理向量,并保留到原文的映射 |
| 检索微调 | 用相关性样本改善查询与文档的表示关系 |
| Reranker | 在候选集合内进一步判断相关性并重排 |
| AP / MAP / nDCG | 评估相关结果的覆盖与排序质量 |
| RAG | 把检索到的外部资料加入上下文,参与答案生成 |
| RAG 评估 | 检查回答相关性、依据、引用、实用性与成本 |
其中最值得记住的是:
- 向量接近是一种检索信号:还需要确认文本是否能回答问题。
- 分块决定可检索粒度:完整覆盖原文,并保留必要上下文与来源。
- 召回与精排分别优化:先让关键资料进入候选,再改善靠前结果的质量。
- RAG 通过上下文提供资料:检索器、重排器与生成模型可以分别设计和替换。
- 回答与引用都要核对:语言流畅、有来源编号,还不足以说明每条事实有依据。
与前面章节连接起来:
第 2 章
→ 文本怎样形成可比较的向量表示

第 6 章
→ 怎样组织模型输入与输出要求

第 7 章
→ 怎样编排模型、状态与工具

第 8 章
→ 怎样找到外部证据,再利用证据生成回答