
3.1 Transformer 模型概述
本章先了解 Transformer 的基础知识,再了解 Transformer 模型自 2017 年问世以来的改进。
3.1.1 已训练 Transformer LLM 的输入和输出
要理解 Transformer LLM 的行为,最常见的方式是将其视为一个接收文本输入并生成响应文本的软件系统。足够大的模型在足够大的高质量数据集上完成训练后,就能生成令人印象深刻且实用的输出。
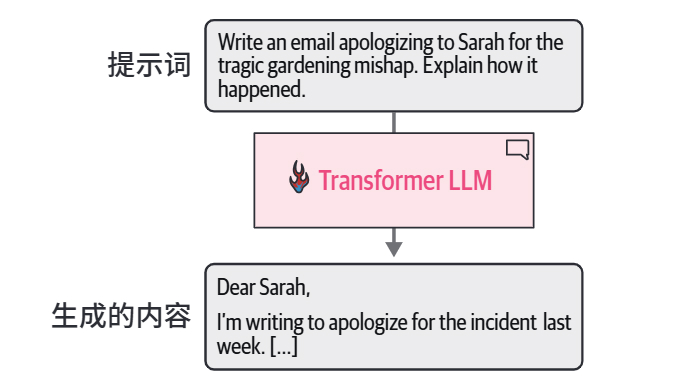
模型并不是一次性生成所有文本,而是一次生成一个词元。每个词元生成步骤都是模型的一次前向传播(forward pass)——输入进入神经网络并流经计算图、最终在另一端产生输出所需的计算过程。
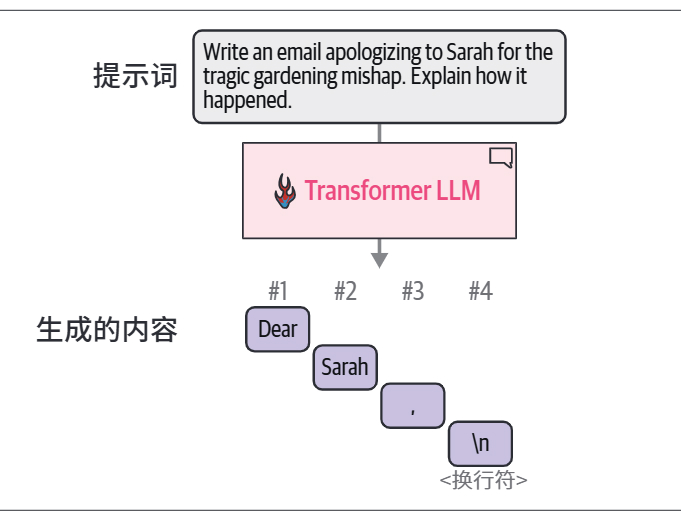
生成当前词元后,输出词元会被追加到输入提示词的末尾,得到的新文本再次提供给模型进行另一次前向传播,以生成下一个词元:
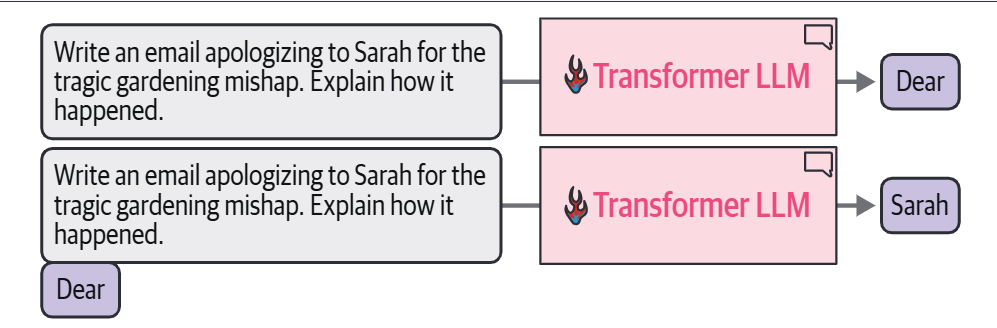
这让我们对模型有了更准确的认识:它只是基于输入提示词预测下一个词元,神经网络外围的软件基本上就是在循环运行这个模型,按顺序扩展生成的文本。
自回归模型(autoregressive model):使用早期预测来进行后续预测的模型(例如用生成的第一个词元来生成第二个词元)。文本生成式 LLM 因此也被称为自回归模型——这一名称用于区分文本生成模型与 BERT 这类非自回归的文本表示模型。
3.1.2 前向传播的组成
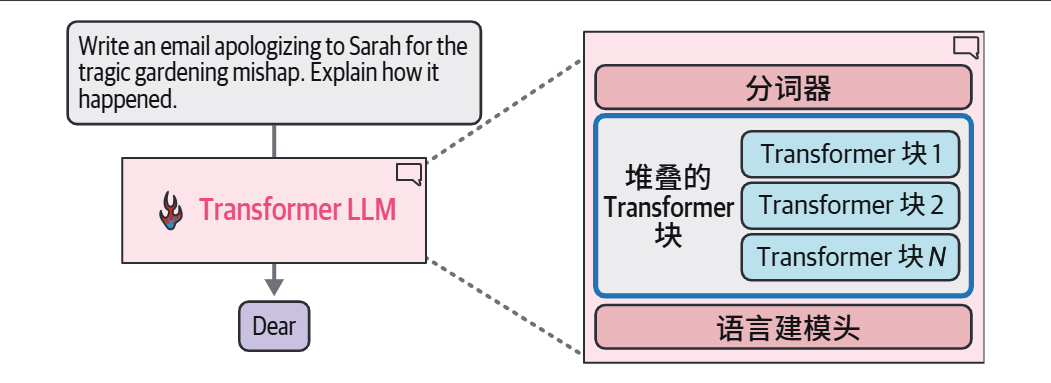
除了循环之外,前向传播还有两个关键的内部组件:分词器和语言建模头(language modeling head,LM head)。分词器之后是由一系列 Transformer 块堆叠而成的神经网络,负责执行所有处理工作;LM head 位于堆叠的块之后,将 Transformer 块的输出转换为预测下一个词元的概率分数。
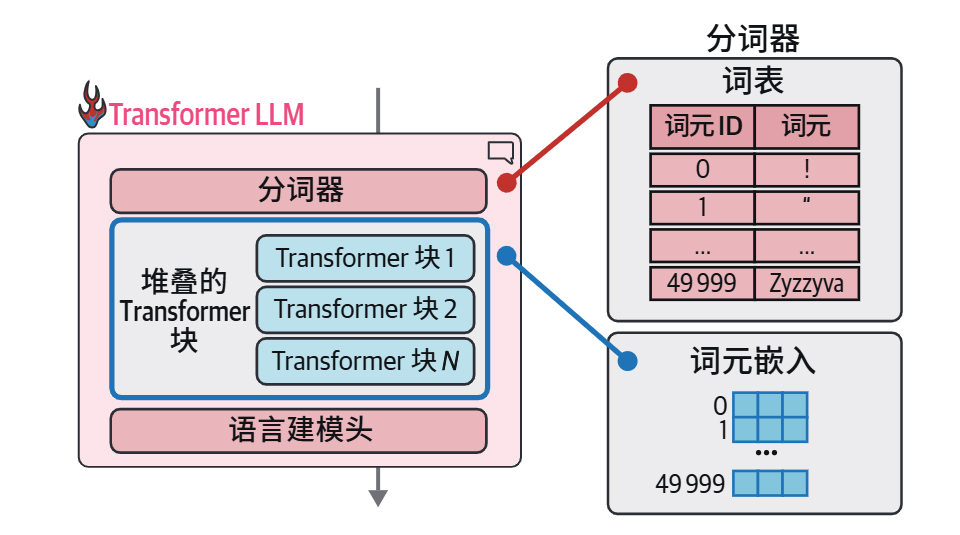
回顾第 2 章:分词器包含词元表(词表),模型为词表中的每个词元都关联了一个向量表示(词元嵌入):
计算流对每个生成的词元按顺序依次经过所有堆叠的 Transformer 块,然后到达 LM head,最后输出下一个词元的概率分布:
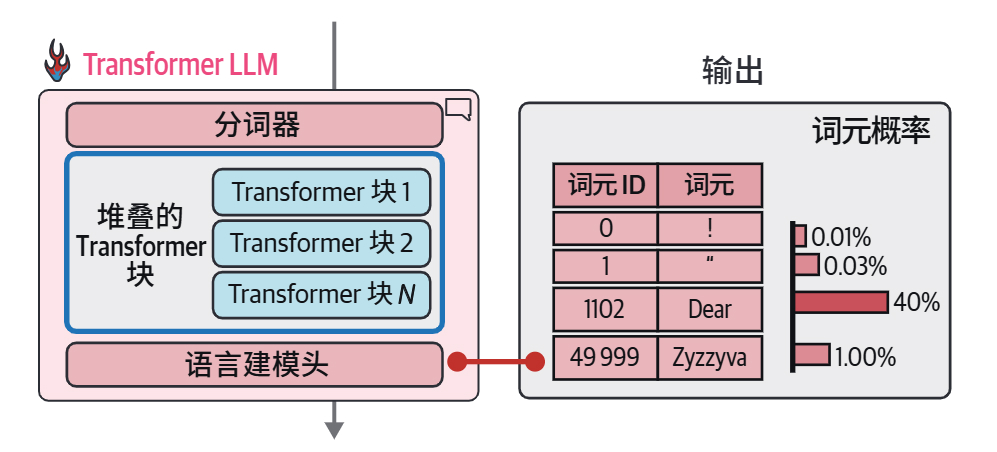
LM head 本身是一个简单的神经网络层。它是可以连接到堆叠的 Transformer 块上的多种可能的"头"之一——其他类型的头还包括序列分类头和词元分类头,用于构建不同类型的系统。
打印 Phi-3 的模型变量,可以按顺序看到所有嵌套层:
Phi3ForCausalLM(
  (model): Phi3Model(
    (embed_tokens): Embedding(32064, 3072, padding_idx=32000)
    (layers): ModuleList(
      (0-31): 32 x Phi3DecoderLayer(
        (self_attn): Phi3Attention(...)
        (mlp): Phi3MLP(...)
        (input_layernorm): Phi3RMSNorm()
        (post_attention_layernorm): Phi3RMSNorm()
      )
    )
    (norm): Phi3RMSNorm()
  )
  (lm_head): Linear(in_features=3072, out_features=32064, bias=False)
)
观察这个结构,可以注意到几个重点:
- 嵌入矩阵
embed_tokens:32,064 个词元,每个词元的向量大小为 3,072 - 主要组件是 32 个堆叠的
Phi3DecoderLayer,每个块都包含一个注意力层和一个前馈神经网络(也称 MLP,多层感知器) - 每个块内有两个
Phi3RMSNorm(input_layernorm与post_attention_layernorm)——归一化的作用将在 3.2.2 节展开 lm_head接收一个 3,072 维向量,输出大小等于词表大小(32,064)的向量,即每个词元的概率分数
3.1.3 从概率分布中选择单个词元(采样/解码)
处理结束时,模型会为词表中的每个词元输出一个概率分数。从概率分布中选择单个词元的方法称为解码策略。
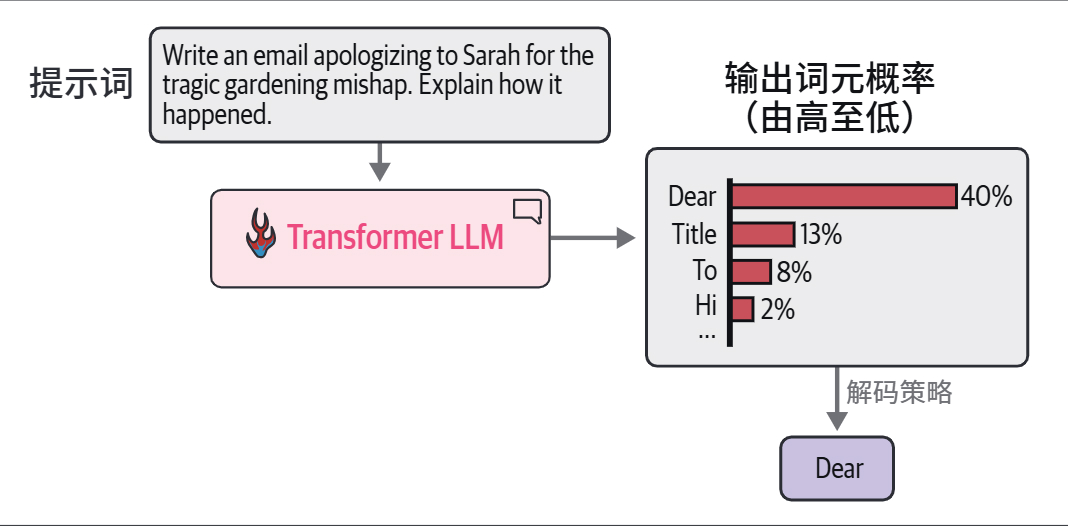
最简单的策略是始终选择概率分数最高的词元——贪心解码(greedy decoding),这就是将温度(temperature)参数设为零时会发生的情况(第 6 章详述)。但在实践中,这种方法往往无法产生最佳输出。更好的方法是引入一些随机性——根据概率分数对概率分布进行采样:如果 Dear 的概率为 40%,它被选中的概率就是 40%,概率第二、第三高的词元也有机会被选中。
书中用代码演示了这个过程——将模型在 LM head 之前的输出传给 lm_head:
# 获取模型在 lm_head 之前的输出
model_output = model.model(input_ids)

# 获取 lm_head 的输出
lm_head_output = model.lm_head(model_output[0])

# 取最后一个位置的分数,获取得分最高的词元 ID 并解码
token_id = lm_head_output[0,-1].argmax(-1)
tokenizer.decode(token_id)
lm_head_output 的形状是 [1, 5, 32064]。[0, -1] 中:索引 0 是批次维度(一批数据中的第一个),-1 取序列中的最后一个词元——于是得到全部 32,064 个词元的概率分数。对提示词 "The capital of France is",得分最高的词元解码后是 Paris。
3.1.4 并行词元处理和上下文长度
Transformer 最引人注目的特性之一是更适合并行计算。分词器将文本分解成词元后,每个输入词元都会流经自己的计算路径(计算流):
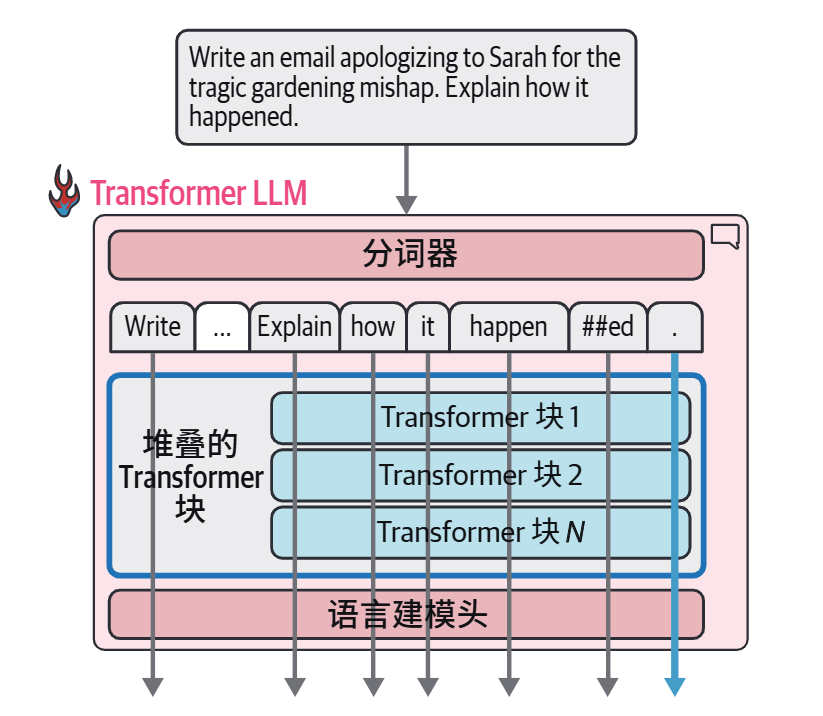
模型对一次可以处理的词元数量有限制,这个限制就是上下文长度——一个 4K 上下文长度的模型只能处理 4,000 个词元,也就是只有 4,000 条这样的流。
每条计算流都从一个输入向量开始(嵌入向量和一些位置信息,位置嵌入本章后面讨论),在流的末尾输出一个大小相同的向量——这个大小通常称为模型维度(model dimension):
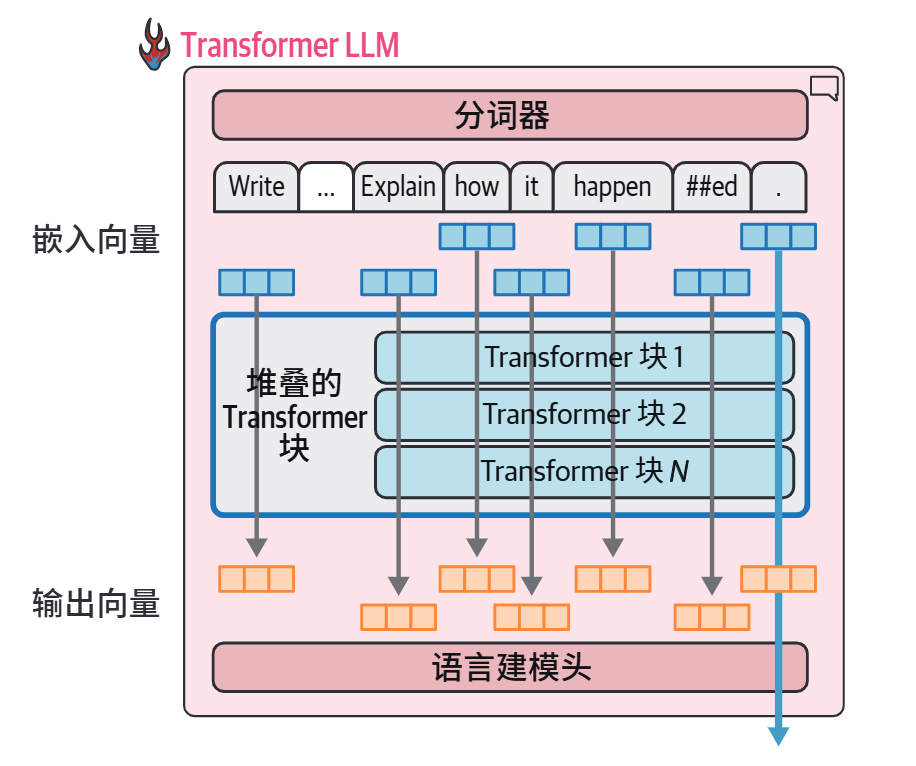
对于文本生成,只有最后一条计算流的输出用于预测下一个词元——LM head 计算概率时,该输出向量是唯一的输入。
一个自然的疑问是:既然最终只用到最后一个词元的输出,为什么还需要所有的计算流?答案是,前序流的计算结果是最终的流所必需的——不直接使用它们的最终输出向量,但会在每个 Transformer 块的注意力机制中使用其早期输出。
Tips:
这正解释了lm_head输入输出的形状关系:输入[1, 5, 3072](1 个批次、5 个词元、每个词元 3,072 维向量),输出[1, 5, 32064](每个位置都对词表给出一组概率分数)。
3.1.5 通过缓存键−值加速生成过程
生成第二个词元时,只是将输出词元追加到输入末尾再做一次前向传播。如果模型能够缓存之前的计算结果(特别是注意力机制中的一些特定向量),就不需要重复计算之前的流,而只需计算最后一条流。这种优化技术称为键-值缓存(key-value cache,KV cache)——键和值是注意力机制的核心组件,能显著加快生成过程。
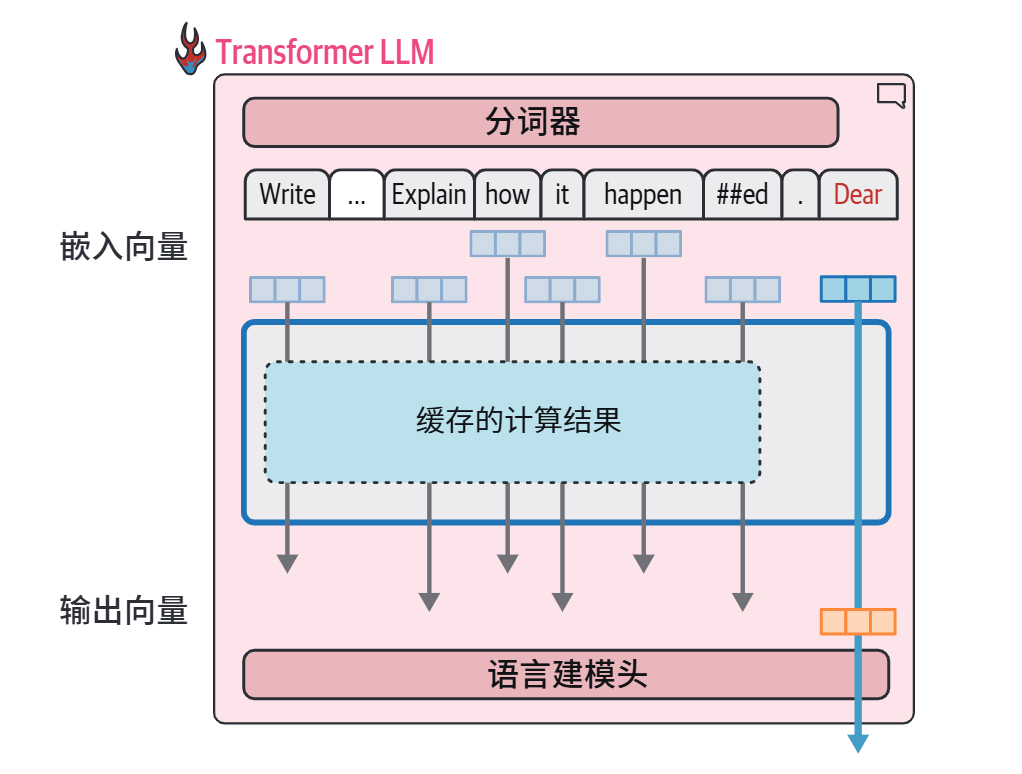
实测差异(T4 GPU,生成 100 个词元):use_cache=True 需要 4.5 秒,use_cache=False 需要 21.8 秒。事实上即使 4 秒,对盯着屏幕等待的用户来说也很长——这就是为什么 LLM API 会在生成过程中流式输出词元,而不是等整个生成完成再输出。
补充理解:
KV Cache 缓存的不是最终的词元嵌入,而是每一层注意力中、历史词元已经计算好的 K/V 激活值。生成新词元时只需计算它自己的 Q/K/V,然后拿新的 Q 去查询缓存中的所有历史 K/V 即可完成注意力。为什么不缓存 Q?因为未来的词元需要查询的是历史词元——历史词元在未来只扮演"被匹配的 K"和"被加权的 V"的角色,它们的 Q 不会再被用到。
这里的Q/K/V更具体的后面会有讲解,这里只用了解大概即可。
3.1.6 Transformer 块的内部结构
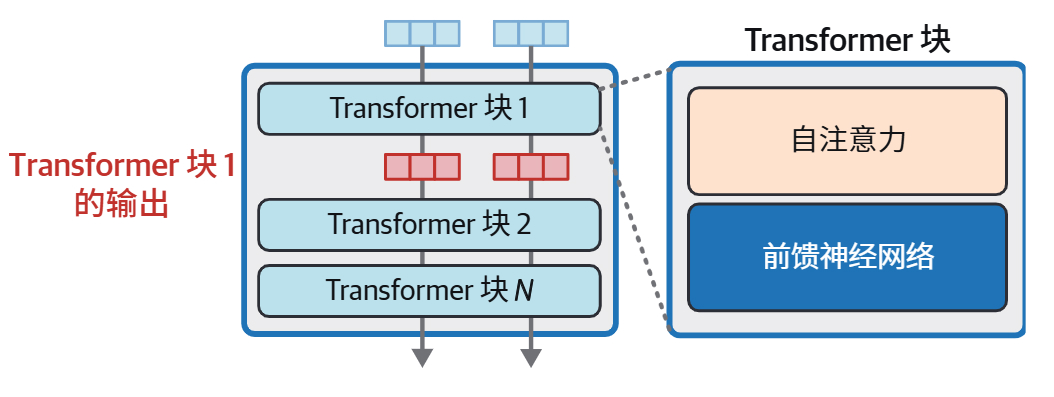
Transformer LLM 的大部分处理过程发生在一系列 Transformer 块中(原始论文中约 6 个,许多 LLM 中超过 100 个),每个块处理其输入,然后把处理结果传递给下一个块:
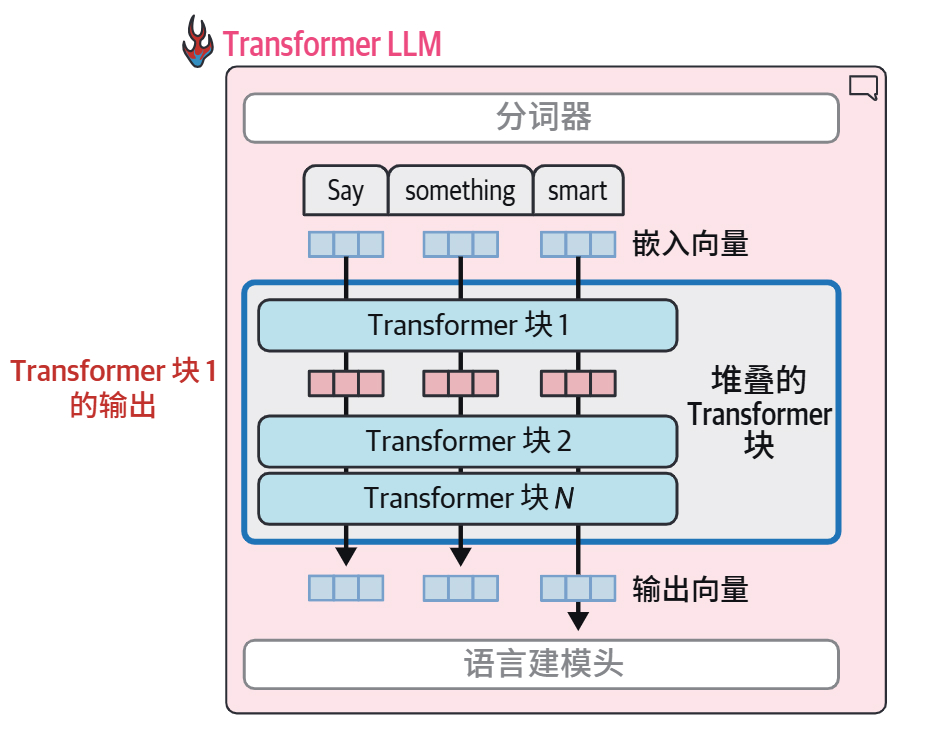
Transformer 块由两个首尾相接的组件构成:
- 自注意力层:主要负责整合来自其他输入词元和位置的相关信息
- 前馈神经网络层:包含模型的主要处理能力
前馈神经网络层概览
用一个简单的例子理解前馈神经网络:向模型输入 The Shawshank,期望它生成 Redemption(1994 年电影《肖申克的救赎》)。前馈神经网络(分布在所有模型层中)就是这些信息的来源——模型在包含大量 "The Shawshank Redemption" 引用的训练数据上完成训练后,学习并存储了完成这项任务所需的信息和行为。
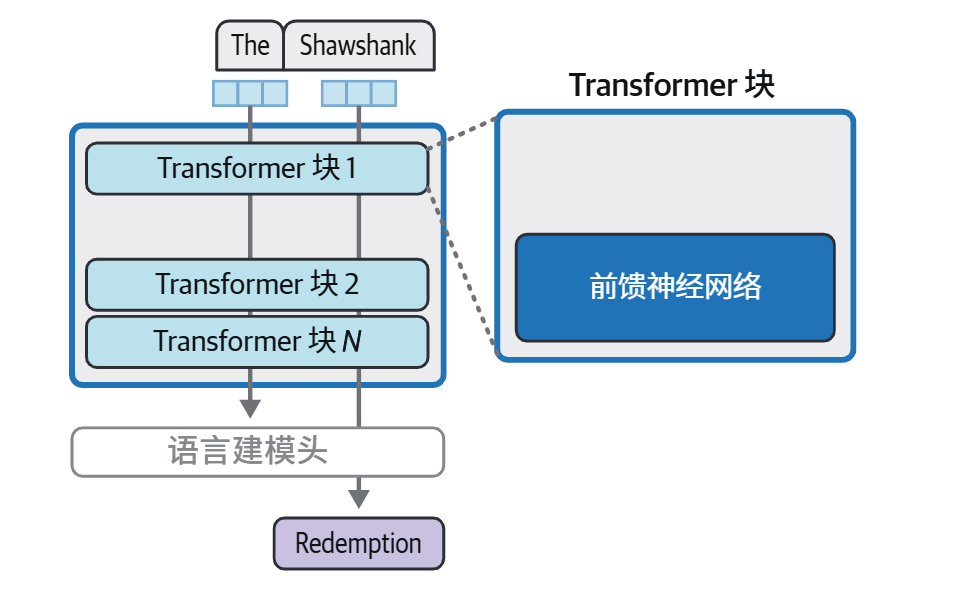
但要成功训练一个 LLM,记忆只是要素之一,模型并不仅仅是一个大型数据库。它能利用相同的机制在数据点之间进行插值、识别更复杂的模式,从而实现泛化——很好地处理以前从未见过、不在训练数据集中的输入。
Tips:
使用现代商用 LLM 时,得到的输出已不是严格意义上"语言模型"的输出——向 GPT-4 输入The Shawshank,它会直接输出一段电影介绍。原始语言模型(如 GPT-3)对用户来说很难用,需要通过指令微调和基于人类偏好与反馈的微调来满足期望(呼应第 1 章 1.2.7 节的指令模型)。
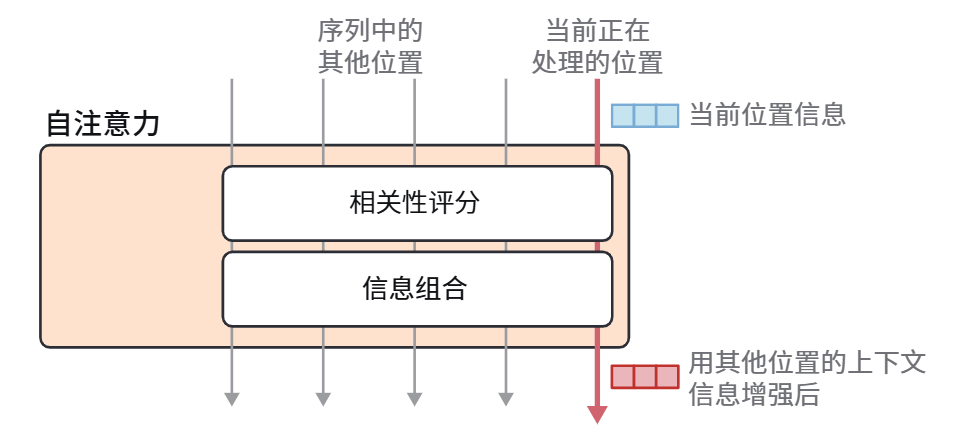
自注意力层概览
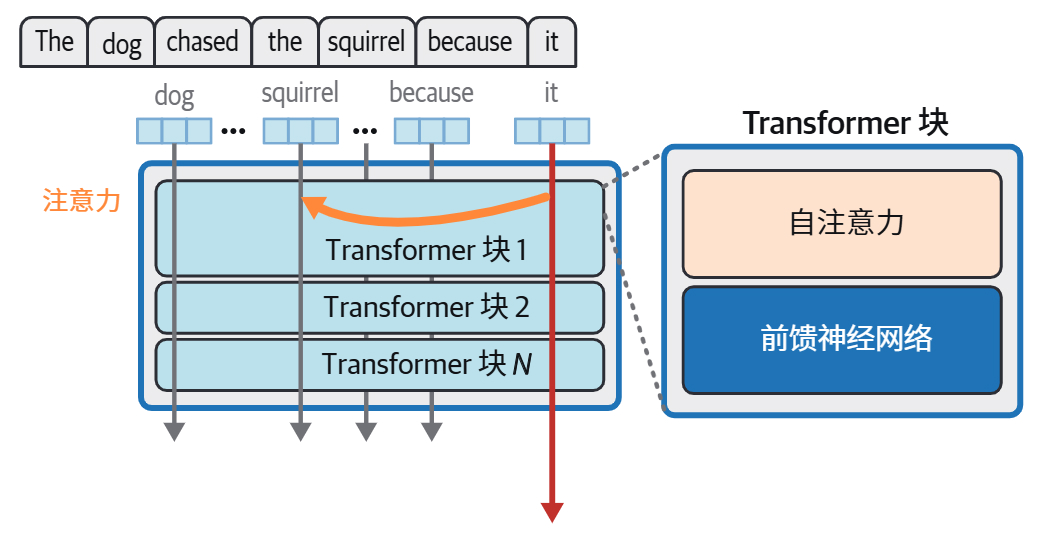
上下文对于语言建模非常重要。仅仅依赖前一个词元,往往不足以判断当前词元真正表达的含义。
例如:
The dog chased the squirrel because it
当模型处理 it 时,需要结合前面的上下文判断:
it → dog ?
还是
it → squirrel ?
Transformer 中的 Self-Attention(自注意力) 就负责解决这类问题。
它的核心作用可以理解为:
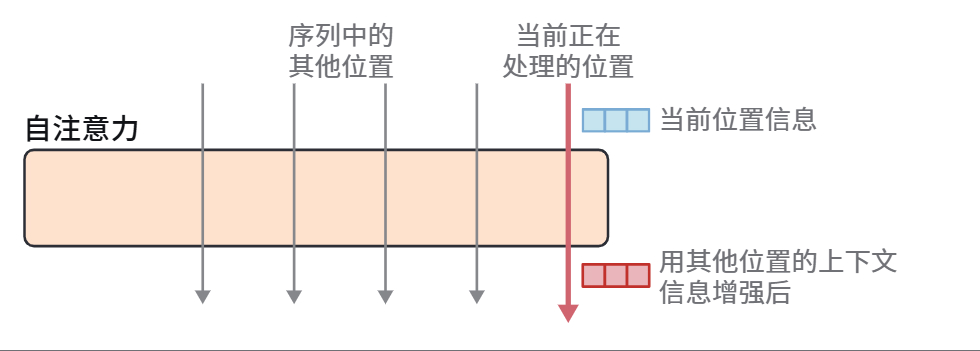
让当前 Token 从上下文中的其他 Token 获取与自己相关的信息,并形成新的上下文化表示。
也就是说,it 原本只有自己当前的隐藏表示,经过 Attention 后,会把前面与它相关的信息融合进来。
注意力机制的基本作用
极简情况下,可以把 Attention 理解成两个步骤:
- 相关性评分:判断当前 Token 应该关注上下文中的哪些 Token,以及关注多少。
- 信息组合:按照这些关注程度,把相关 Token 提供的信息组合成一个新的向量。
因此可以概括为:
当前 Token
↓
先判断“谁和我最相关”
↓
得到注意力权重
↓
再按照权重读取这些 Token 的信息
↓
组合成新的上下文表示
多头注意力
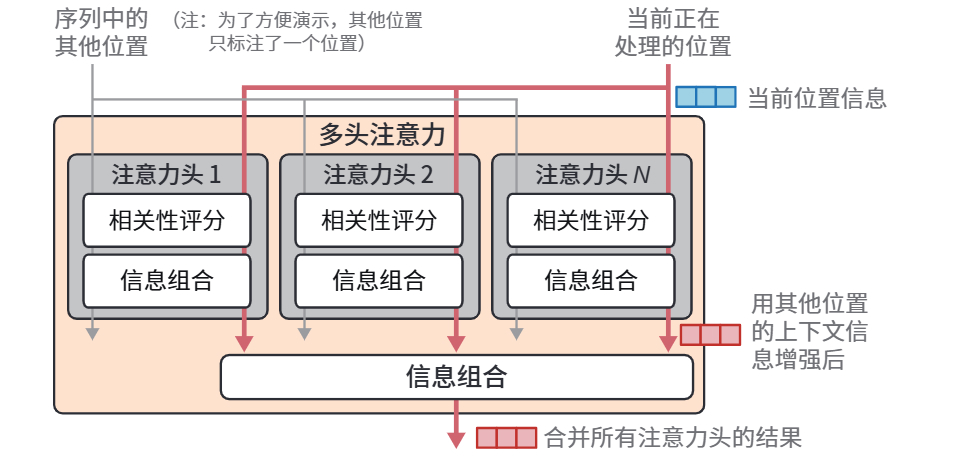
为了让模型能够同时学习不同类型的关系,Transformer 不只进行一次 Attention,而是并行进行多组 Attention 计算。
每一组独立的 Attention 计算称为一个:
Attention Head(注意力头)
可以粗略理解为:
Head 1 → 关注一种关系
Head 2 → 关注另一种关系
Head 3 → 关注另一种关系
...
例如不同的 Head 可能分别学到:
语法关系
指代关系
实体关系
远距离依赖
局部关系
这些关系不是人工规定的,而是在训练过程中由模型自己学习得到的。(注意这里我们上述只是为了辅助理解才这么说的,实际上是模型自己学习的某种关系)
Q、K、V 是怎么产生的
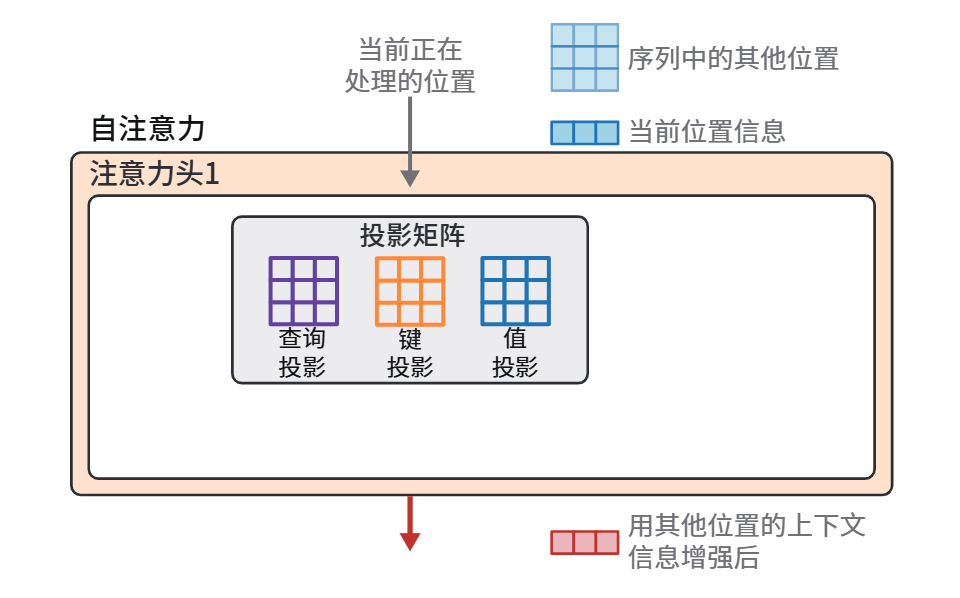
每个 Token 都是以当前自己的隐藏表示 X(每个token的初始表示 + 位置信息)作为输入进入一个 Transformer Block 的 Attention。
Attention 会使用这一层(每个注意力头都有)已经训练好的三个投影矩阵:
W_Q
W_K
W_V
把当前隐藏表示分别投影成:
Q
K
V
即:
其中:
W_Q:Query 投影矩阵W_K:Key 投影矩阵W_V:Value 投影矩阵
这些投影矩阵是模型训练过程中学习得到的参数。
对于标准 Transformer,可以先理解成:
每个 Transformer Block 都有自己的一组 Attention 投影参数。
而 Q、K、V 不是固定参数,它们是模型运行时根据当前输入 X 临时计算出来的激活值。
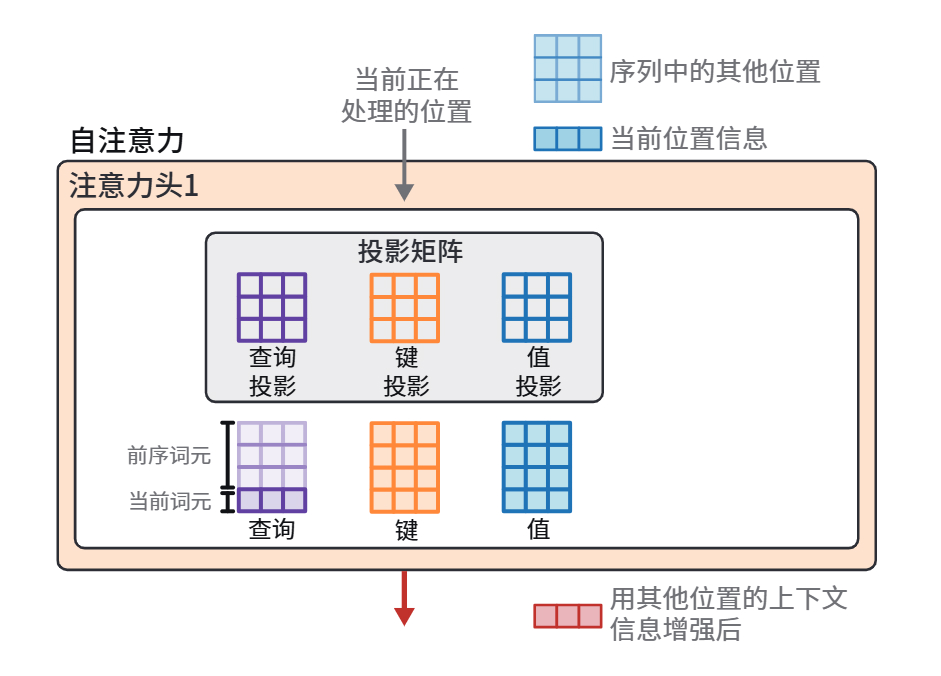
可以把 Q、K、V 粗略理解为:
| 向量 | 直觉理解 |
|---|---|
| Q(Query) | 我现在想找什么信息? |
| K(Key) | 我身上有哪些特征,可以和你的 Query 匹配? |
| V(Value) | 如果你关注我,我真正提供什么信息? |
一句话:
Q 负责“查询”,K 负责“匹配”,V 负责“提供实际信息”。
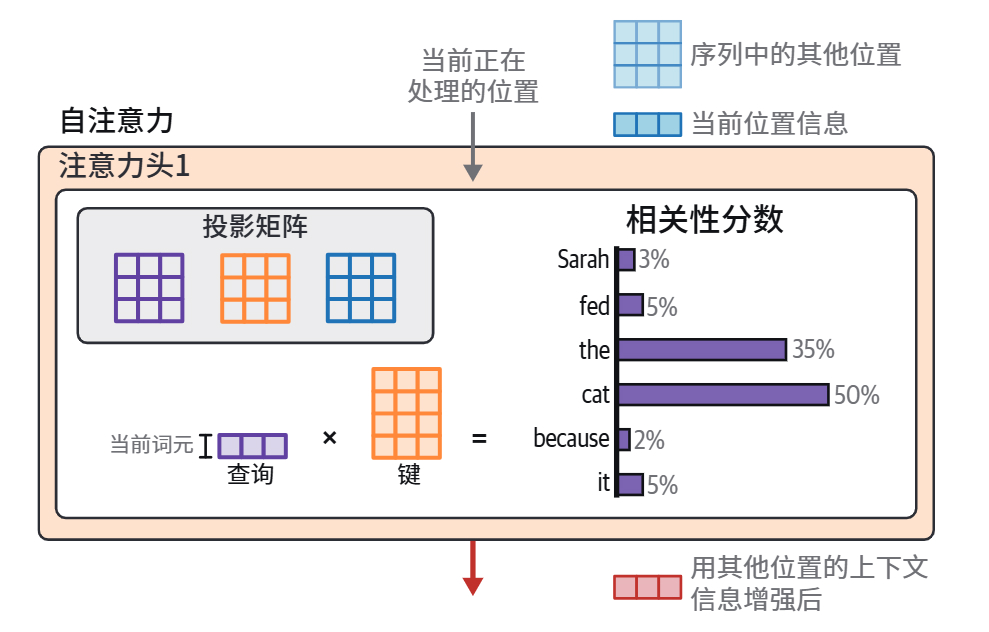
自注意力第一步:相关性评分
还是以:
Sarah fed the cat because it
为例。
假设当前关注的是最后一个 Token:
it
it 有自己的 Query:
Q_it
前面每个 Token 都有自己的 Key:
K_Sarah
K_fed
K_the
K_cat
K_because
K_it
于是 Q_it 会分别和这些 K 做点积:
Q_it · K_Sarah
Q_it · K_fed
Q_it · K_the
Q_it · K_cat
Q_it · K_because
Q_it · K_it
得到一组原始相关性分数:
Sarah     → score₁
fed       → score₂
the       → score₃
cat       → score₄
because   → score₅
it        → score₆
这些分数表示:
从
it当前的 Query 看,各个 Token 的 Key 与它有多匹配。
然后经过 Softmax:
原始相关性分数
↓
Softmax
↓
Attention Weights
例如得到:
Sarah      3%
fed        5%
the       10%
cat       70%
because    4%
it         8%
这里的数字只是为了方便理解,仅供参考。
Softmax 后:
所有权重 ≥ 0
所有权重之和 = 1
因此可以理解为:
谁的 Attention Weight 越高,当前 Token 就越倾向于从谁那里读取信息。
自注意力第二步:信息组合
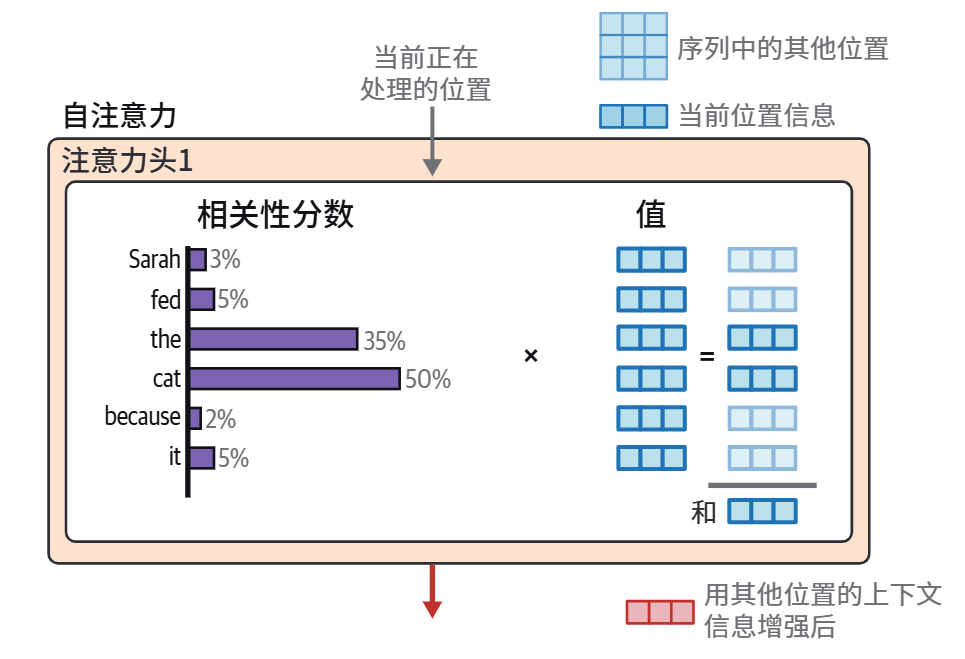
有了 Attention Weight 后,K 的主要任务就完成了。
接下来开始读取每个 Token 的 Value。
假设 it 得到:
Sarah      3%
fed        5%
the       10%
cat       70%
because    4%
it         8%
那么会计算:
3%  × V_Sarah
+
5%  × V_fed
+
10% × V_the
+
70% × V_cat
+
4%  × V_because
+
8%  × V_it
最后把这些向量全部相加,得到:
AttentionOutput_it
也就是说:
相关性评分决定“从谁那里读取多少信息”,V 则是真正被读取和组合的信息。
如果 cat 的权重最高,那么最终得到的 Attention Output 中,就会较多地融合 cat 的信息。
因此可以粗略理解为:
it
↓
Q_it 去查询所有 K
↓
发现 K_cat 最匹配
↓
cat 获得较高 Attention Weight
↓
读取更多 V_cat
↓
把 V_cat 与其他位置的 V 按权重组合
↓
得到新的 AttentionOutput_it
用一句具体例子串起来
还是:
The dog chased the squirrel because it
假设当前处理 it。
第一步,it 的 Q 查询前面所有允许看到的 K:
Q_it · K_The
Q_it · K_dog
Q_it · K_chased
Q_it · K_the
Q_it · K_squirrel
Q_it · K_because
Q_it · K_it
得到分数后经过 Softmax,例如:
The        2%
dog       10%
chased     5%
the        3%
squirrel  65%
because    5%
it        10%
第二步,用这些权重读取对应的 V:
2%  × V_The
+
10% × V_dog
+
5%  × V_chased
+
3%  × V_the
+
65% × V_squirrel
+
5%  × V_because
+
10% × V_it
最后相加得到:
AttentionOutput_it
由于 squirrel 获得了较高权重,所以新的 it 表示中会较多地融合与 squirrel 有关的信息。
可以把整个过程压缩成:
Q:我要找谁?
↓
和所有 K 比较
↓
得到 Attention Weight
↓
谁更相关,权重就更高
↓
用这些权重读取对应的 V
↓
所有 V 加权求和
↓
得到新的上下文信息
注意:生成一个 Token,不等于 Attention 永远只计算最后一个位置
在自回归生成阶段,模型确实是:
生成一个 Token
↓
追加到序列
↓
再生成下一个 Token
但第一次处理已有 Prompt(Prefill)或者训练时,同一个 Transformer Block 中的多个 Token 可以并行计算。
例如:
Sarah
fed
the
cat
because
it
会一起生成这一层的:
Q
K
V
然后一起参与 Attention 计算。
因此:
“当前 Token 的 Q 查询前面的 K”是理解单个位置 Attention 的方式;实际矩阵计算中,同一层的多个位置通常可以并行完成这些操作。
从一个 Block 到生成下一个 Token完整流程
以:
Sarah fed the cat because it
为例,完整走一遍 QKV 在 Transformer 中的计算流程。
1. 第一个 Transformer Block:所有 Token 一起计算 QKV
整段文本经过 Tokenizer、Embedding 等处理后,可以得到每个 Token 当前的隐藏表示:
X⁰_Sarah
X⁰_fed
X⁰_the
X⁰_cat
X⁰_because
X⁰_it
把整段序列的表示整体记作:
X⁰
然后在当前 Transformer Block 中,所有 Token 一起计算 Q、K、V。
其中:
- X^{(0)}:进入第 1 个 Block 的整段 Token 表示
- W_Q^{(1)}:第 1 个 Block 的 Query 投影矩阵
- W_K^{(1)}:第 1 个 Block 的 Key 投影矩阵
- W_V^{(1)}:第 1 个 Block 的 Value 投影矩阵
- Q^{(1)}、K^{(1)}、V^{(1)}:第 1 个 Block 运行时产生的 Q/K/V
于是得到:
Sarah    → Q¹_Sarah    K¹_Sarah    V¹_Sarah
fed      → Q¹_fed      K¹_fed      V¹_fed
the      → Q¹_the      K¹_the      V¹_the
cat      → Q¹_cat      K¹_cat      V¹_cat
because  → Q¹_because  K¹_because  V¹_because
it       → Q¹_it       K¹_it       V¹_it
这里的“并行”指:
同一个计算阶段中,整段序列的所有 Token 一起完成 Q、K、V 投影。
并不是某个 Token 算完 QKV 后,自己先继续往后执行。
可以理解为:
Block 1
所有 Token
↓
一起计算 QKV
↓
一起计算 Attention
↓
一起经过后续计算
↓
得到所有 Token 的 X¹
这里理解可能比较难,看完 2. Q 和 K 计算相关性 就能理解了。
2. Q 和 K 计算相关性
当这一层所有 Token 的 Q、K 都计算完成后,统一计算:
得到 Attention Score 矩阵。
可以理解成:
Key
             Sarah  fed  the  cat  because  it

Q_Sarah       ●
Q_fed         ●     ●
Q_the         ●     ●    ●
Q_cat         ●     ●    ●    ●
Q_because     ●     ●    ●    ●      ●
Q_it          ●     ●    ●    ●      ●      ●
本质上:
每一个位置的 Q,都在与允许看到的位置的 K 进行点积匹配。
例如最后一个 Token it:
Q_it
↓
和 K_Sarah 点积
和 K_fed 点积
和 K_the 点积
和 K_cat 点积
和 K_because 点积
和 K_it 点积
得到一组相关性分数。
可以看到,在这一步,我们需要将Q * X。且是当前位置的Q 与 所有其他词元的K进行相乘。 所有承接上一节最后解释的,如果不是一起计算KQV(计算KQV,有些快有些慢,但是他们都不允许擅自计算完KQV后继续执行,必须等待所有KQV计算完),那么在Attention,那么有些Q * X 是不完整的,缺少了信息。
3. Causal Mask:不能看未来
在 GPT 这类因果语言模型中,当前位置只能看到:
自己
+
自己之前的 Token
例如:
Sarah
→ 只能看 Sarah

fed
→ 可以看 Sarah、fed

the
→ 可以看 Sarah、fed、the

cat
→ 可以看 Sarah、fed、the、cat

because
→ 可以看 Sarah、fed、the、cat、because

it
→ 可以看 Sarah、fed、the、cat、because、it
未来位置的 Attention Score 会通过 Mask 被屏蔽。
所以虽然数学上可以一次算出整个:
但真正允许参与 Attention 的位置由 Mask 决定。
前面的2. Q 和 K 计算相关性 里已经体现出使用Mask后的效果。
4. Softmax:把分数变成注意力权重
流程:
QKᵀ
↓
Mask
↓
Softmax
↓
Attention Weights
Softmax 会把每一行的相关性分数转成权重,并且:
每一行所有权重之和 = 1
假设 it 这一行与其他进行相关性计算后通过softmax就可以得到:
Sarah      3%
fed        5%
the       35%
cat       50%
because    2%
it         5%
5. 根据注意力权重加权 V
得到权重以后,不再继续使用 K。
K 的任务到这里基本已经完成:
K 主要负责和 Q 做匹配,决定“关注谁”。
接下来真正读取的是 V。
对于 it:
3%  × V¹_Sarah
+
5%  × V¹_fed
+
35% × V¹_the
+
50% × V¹_cat
+
2%  × V¹_because
+
5%  × V¹_it
也可以写成:
最终得到:
AttentionOutput¹_it
如果 cat 的权重较高,那么 it 得到的上下文信息中,就会较多地融合 cat 提供的信息。
因此 Attention 可以粗略理解成:
Q 查询 K,得到“应该关注谁、关注多少”的权重,再按照这些权重读取并汇总 V。
6. 一个 Block 中的 Attention 核心公式
标准 Attention 可以概括成:
其中:
- QK^T:计算 Q 和 K 的相关性
- \sqrt{d_k}:用于缩放分数
Softmax:转换成注意力权重- 最后乘 V:按照权重汇总真正的信息
如果加入因果 Mask,可以粗略写成:
7. 得到这一层新的 Token 表示
Attention 计算结束以后,每个 Token 都会得到自己的 Attention Output。
例如:
Sarah    → AttentionOutput¹_Sarah
fed      → AttentionOutput¹_fed
the      → AttentionOutput¹_the
cat      → AttentionOutput¹_cat
because  → AttentionOutput¹_because
it       → AttentionOutput¹_it
然后还会继续经过当前 Transformer Block 后面的 FFN 等计算。
这里暂时省略残差连接和归一化(后边会讲这个,这里先忽略掉),只关注主流程:
Attention Output
↓
FFN
↓
得到这一层新的隐藏表示 X¹
所以第一个 Block 可以简化成:
X⁰
↓
计算 Q¹、K¹、V¹
↓
Q¹(K¹)ᵀ
↓
Mask
↓
Softmax
↓
加权 V¹
↓
Attention Output
↓
FFN
↓
X¹
此时整段序列已经得到新的表示:
X¹_Sarah
X¹_fed
X¹_the
X¹_cat
X¹_because
X¹_it
8. 进入 Block 2:重新计算新的 QKV
进入第二个 Transformer Block 时,输入已经不是原来的 X^{(0)}。
而是:
X¹
因此第二个 Block 必须重新计算自己的 Q/K/V。
然后再次执行:
Q²(K²)ᵀ
↓
Mask
↓
Softmax
↓
加权 V²
↓
Attention Output
↓
FFN
↓
X²
9. 多层 Transformer 的整体计算流程
假设模型有 32 个 Transformer Block:
X⁰
↓
Block 1
↓
Q¹ K¹ V¹
↓
Attention
↓
FFN
↓
X¹
====================
X¹
↓
Block 2
↓
Q² K² V²
↓
Attention
↓
FFN
↓
X²
====================

X²
↓
Block 3
↓
Q³ K³ V³
↓
Attention
↓
FFN
↓
X³

...

====================

Block 32
↓
X³²
也就是:
X⁰ → X¹ → X² → X³ → ... → X³²
每一层都在上一层已经得到的新表示基础上:
再重新判断当前 Token 应该关注谁,以及应该从上下文中读取什么信息。
10. 最后怎样预测下一个 Token?
经过全部 32 个 Transformer Block 后,会得到整段序列最终的隐藏表示:
X³²_Sarah
X³²_fed
X³²_the
X³²_cat
X³²_because
X³²_it
现在模型要预测:
Sarah fed the cat because it [???]
因此生成下一个 Token 时,主要使用最后位置 it 的最终隐藏表示:
X³²_it
↓
LM Head
↓
Vocabulary Logits
↓
Softmax
↓
词表概率分布
↓
根据解码策略选择下一个 Token
例如:
was
于是序列变成:
Sarah fed the cat because it was
新 Token 追加到输入,继续循环上述流程
但是注意,前面已经生成过的QKV都会缓存到对应的Transformer块内的,所以不用重新计算。所有新token输入后,也是上述流程,只不过是它一个计算QKV,然后计算权重等等流程。
3.2 Transformer 架构的最新改进
Transformer 发布以后,后续模型并没有推翻它的核心结构,而是在 Attention、归一化、位置编码、FFN 等部分不断进行优化。
其中 Attention 是重点优化对象之一。
原因是:随着上下文长度增加,Attention 需要处理的 Token 两两关系迅速增加,计算量和显存占用都会明显上升。
因此后续出现了多种优化方向,例如:
减少需要关注的 Token
→ Sparse Attention / Sliding Window Attention

减少需要保存的 K/V
→ MQA / GQA

优化 GPU 上 Attention 的实现
→ FlashAttention
3.2.1 更高效的注意力机制
稀疏注意力
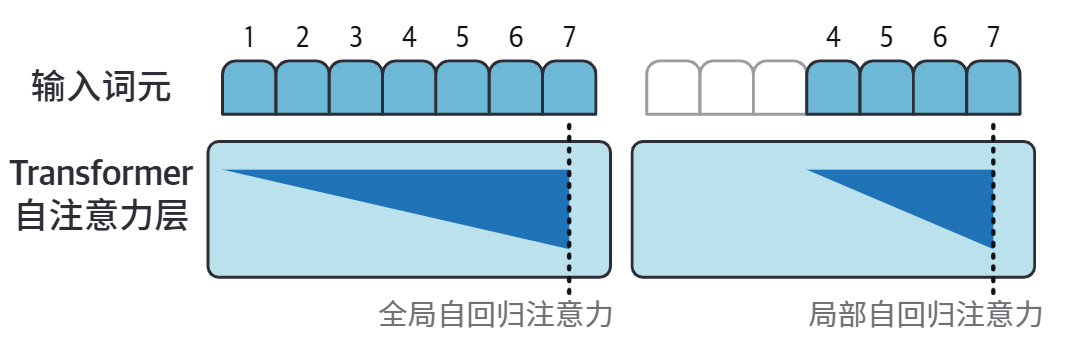
标准的因果全注意力中,当前位置可以关注:
自己
+
自己之前的所有 Token
例如:
Token 1 → 1
Token 2 → 1 2
Token 3 → 1 2 3
Token 4 → 1 2 3 4
...
随着序列长度增加,需要计算的 Token 两两关系也会快速增加。
如果序列长度为 N,完整 Attention Score 矩阵的规模大致为:
N × N
因此上下文越长,Attention 的计算和存储开销就越大。
**Sparse Attention(稀疏注意力)**的核心思想就是:
不让当前 Token 与所有历史 Token 都直接进行 Attention,而是按照一定规则,只选择其中一部分位置参与计算。
需要注意:
Sparse Attention 是一个总称,并不是只有一种固定的连接方式。
很多稀疏注意力方案都会同时考虑两个问题:
附近的信息怎么办?
+
很远的信息怎么办?
因此一种常见设计思路是:
局部连接
+
少量远距离连接
在 Sparse Transformer 中,可以重点理解两种组合模式:
Strided Attention
= 局部连续关注
+ 按固定步长建立远距离连接
Fixed Attention
= 局部块内关注
+ 历史块中的固定位置连接
局部注意力:先保证附近的信息能够直接交流
很多稀疏注意力方案都会保留一部分 Local Attention(局部注意力)。
它的核心思想是:
当前 Token 连续关注距离自己较近的一段 Token。
例如当前处理 K:
A B C D E F G H I J [K]
            ↑ ↑ ↑ ↑ ↑
            G H I J K
当前 K 可以直接关注最近的一段:
G H I J K
而不是:
A B C D E F G H I J K
↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑
全部都计算 Attention
这种局部关注可以较好地保留:
相邻词关系
短语关系
局部语法关系
附近上下文
同时减少 Attention 的连接数量。
只关注一个局部窗口的思想,经常也会看到:
Local Attention
Sliding Window Attention
这样的名称。
但在这里需要特别注意:
在 Sparse Transformer 的 Strided 和 Fixed 方案中,“局部关注”只是整套稀疏连接的一部分,并不是整套方案的全部。
Strided Attention:附近连续看,远处隔着看
Strided Attention 不应该简单理解成:
只隔几个 Token 看一个
它实际上由两部分组成:
局部连续关注
+
按固定步长的远距离关注
假设当前位置是:
13
局部部分可以关注最近的位置:
9  10  11  12  13
↑   ↑   ↑   ↑   ↑
连续关注附近 Token
与此同时,再增加一种跨步式连接:
1 → 5 → 9 → 13
也就是每隔固定距离选择一个位置。
因此当前位置 13 的 Attention 候选位置可以粗略理解成:
局部:

9 10 11 12 13

+

远距离:

1 5 9 13
这样就同时解决了两个问题:
局部连续关注
→ 保留附近细节

跨步远距离关注
→ 用较少连接接触更远的信息
所以可以直接记:
Strided Attention = 附近连续看 + 远处按固定步长跳着看。
也可以写成:
Local
+
Stride
Fixed Attention:块内正常看,跨块只看固定位置
Fixed Attention 的思想和 Strided 不一样。
它不是从当前位置开始:
每隔几个 Token 往回跳
而是先把整个序列划分成多个 Block。
例如每 4 个 Token 一块:
Block 1:1  2  3  4
Block 2:5  6  7  8
Block 3:9 10 11 12
Block 4:13 14 15 16
然后 Attention 分成两部分。
第一部分:
当前 Block 内部进行局部 Attention
例如 Token 15 位于:
Block 4:

13 14 15 16
      ↑
按照因果规则,Token 15 可以直接关注:
13、14、15
这就是:
局部块内关注。
但如果只有这种局部块内连接,就会出现一个问题:
Token 15
只能看到 Block 4

看不到:
Block 1
Block 2
Block 3
因此 Fixed Attention 又增加了第二部分:
在每个历史 Block 中,预先规定相同位置的一小组 Token,作为跨 Block 的固定连接点。
为了方便理解,假设每个 Block 只选择最后一个位置:
Block 1:1  2  3 [4]
                   ↑

Block 2:5  6  7 [8]
                   ↑

Block 3:9 10 11 [12]
                     ↑
那么当处理 Token 15 时,可以粗略理解成它允许关注:
历史 Block 的固定位置:

4
8
12

+

当前 Block:

13
14
15
因此:
Token 15
→ 4、8、12、13、14、15
可以画成:
Block 1      Block 2       Block 3          Block 4

1 2 3 [4] | 5 6 7 [8] | 9 10 11 [12] | [13][14][15] 16
       ↑           ↑             ↑        ↑   ↑   ↑
       └───────────┴─────────────┴────────┴───┴───┘
                       Token 15 可以关注
这就是 Fixed Attention 中:
局部块内关注
+
固定位置远距离关注
需要注意:
“每块最后一个 Token”只是为了方便理解的简化例子。
真正的 Fixed Attention 可以在每个 Block 中固定选择:
1 个位置
或
一小段位置
作为跨 Block 的连接点。
所以 Fixed 的“固定”真正指的是:
每个 Block 都按照预先规定的相同位置规则选择跨块连接点。
而不是:
从当前 Token 出发,每隔固定距离往回跳
Strided 和 Fixed 到底有什么区别?
两种方案其实都有:
局部连接
+
远距离连接
真正区别在于:
远距离连接是怎么选择的?
Strided:
从当前位置出发
↓
按照固定步长选择远距离位置
例如:
13 → 9 → 5 → 1
可以记成:
远处隔着看。
Fixed:
先把序列划分成 Block
↓
每个历史 Block 预先规定固定连接位置
↓
后面的 Token 可以关注这些位置
例如简化成:
Block 1 → 4
Block 2 → 8
Block 3 → 12
可以记成:
块内正常看,跨块看固定“信息站点”。
所以:
Strided
=
Local
+
按步长的远距离连接
Fixed
=
Local Block
+
固定位置的跨块连接
Sparse Transformer 的图怎么看?
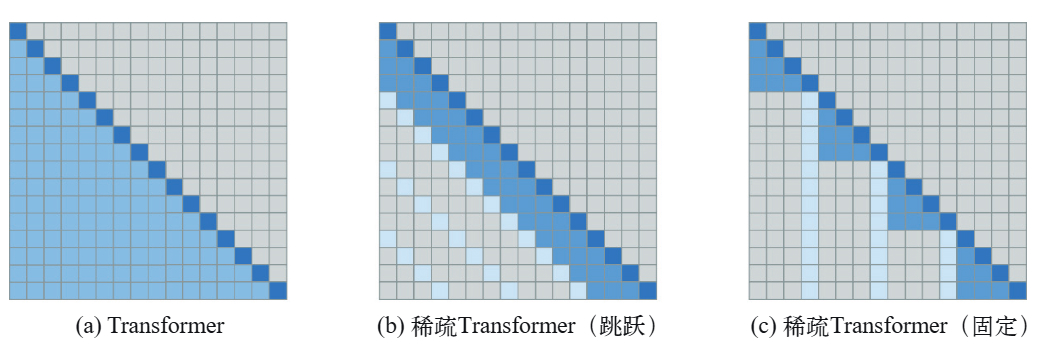
三张图可以分别理解成:
(a) Full Attention
→ 所有历史位置都可以直接关注
(b) Strided Sparse Attention
→ 附近连续关注
+
远处按照固定步长建立连接
(c) Fixed Sparse Attention
→ 当前 Block 内局部关注
+
历史 Block 中固定位置的跨块连接
这里不要单纯根据:
深蓝
中蓝
浅蓝
来判断是哪一种 Attention。
真正应该看的是:
蓝色格子的排列位置和连接规律。
例如:
Strided
→ 会看到局部带状区域
  +
  有规律的跨步连接
而:
Fixed
→ 会看到沿对角线分布的局部块
  +
  周期性出现的固定跨块连接
稀疏注意力只是决定“谁有资格参与”
Sparse Attention 解决的是:
当前 Token 允许和哪些 Token 进行 Attention?
它并不会提前知道:
这些 Token 中谁最重要
例如稀疏 Pattern 最终允许当前 Token 看到:
A
E
G
H
I
J
K
接下来仍然要正常执行:
Q × Kᵀ
↓
Softmax
↓
Attention Weight
例如:
A     5%
E    10%
G     3%
H     7%
I    15%
J    50%
K    10%
因此两件事一定要区分:
Sparse Pattern
→ 决定“允许看谁”
QK + Softmax
→ 决定“实际重点看谁”
也就是说:
Sparse Attention 先缩小候选范围,真正的相关性仍然由 Q、K 和 Softmax 决定。
为什么还需要 Full Attention?
Sparse Attention 的优势很明显:
减少 Attention 连接数量
↓
减少计算开销
但也有代价:
某些没有被 Sparse Pattern 选中的 Token,在这一层无法被当前位置直接访问。
因此一些架构会组合:
Dense / Full Attention
+
Sparse Attention
例如 GPT-3 的架构采用了 Dense Attention 与 Locally Banded Sparse Attention 交替的方式。
可以简单理解成:
某些 Block
→ Full Attention

某些 Block
→ Sparse Attention

交替出现
这样可以在:
完整的信息交互能力
和
较低的 Attention 计算成本
之间进行折中。
Attention 图中的因果关系
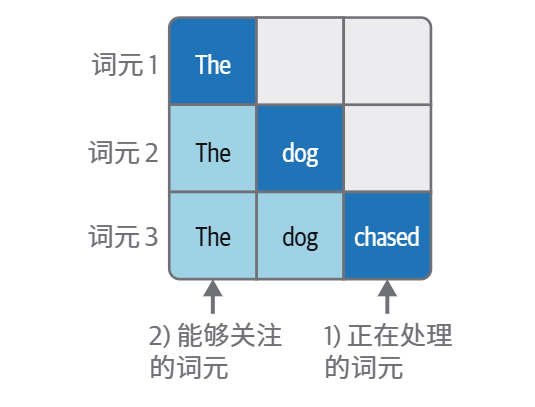
GPT 这类 Decoder-only Transformer 还受到 Causal Mask 的限制:
当前位置
→ 可以看自己
→ 可以看前面的 Token
→ 不能看未来 Token
例如:
The
→ The

dog
→ The、dog

chased
→ The、dog、chased
Sparse Attention 是在这个基础上进一步规定:
“前面的 Token 中,又允许看哪些?”
所以两者作用不同:
Causal Mask
→ 禁止看未来

Sparse Pattern
→ 在允许的历史位置中进一步减少连接
相比之下,BERT 使用双向 Self-Attention,可以同时利用当前位置左右两侧的上下文。
一句话总结
Sparse Attention 的核心是减少每个 Token 需要直接进行 Attention 的位置数量。很多方案都会保留局部连接,再加入少量远距离连接:Strided Attention 使用“局部连续关注 + 按固定步长的远距离连接”,Fixed Attention 使用“块内局部关注 + 历史块中固定位置的跨块连接”。Sparse Pattern 只决定哪些位置有资格参与 Attention,真正的相关性仍然通过 QK 和 Softmax 计算。
多查询注意力和分组查询注意力
除了减少“需要关注多少 Token”,还有另一条优化路线:
减少 Attention 中需要生成和缓存多少组 K/V。
这就引出了:
MHA
↓
MQA
↓
GQA
它们的核心区别并不是 Attention 公式发生了变化,而是:
Query Head 和 KV Head 之间采用了不同的共享关系。
我们前面讲过Attention不止做一次计算,而是根据注意力头数量做多次计算。并且每个注意力头都有自己的投影矩阵,所以每个注意力头都是要产生QKV。所以这些QKV储存下来是需要大量地方,且进行传输时也会有更大的开销,所以本节介绍常见的QKV优化方法。
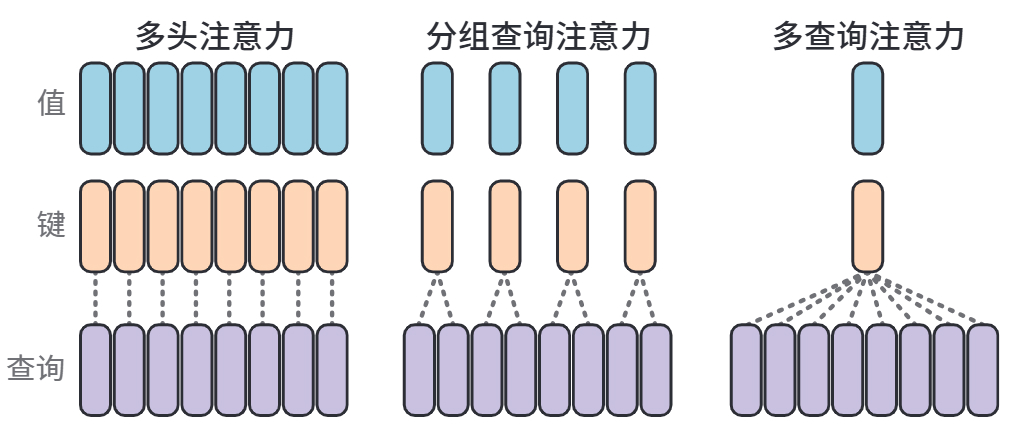
MHA:Multi-Head Attention
标准多头注意力中,假设有 8 个 Attention Head。
可以先概念化理解成:
Head 1:
Q1 / K1 / V1

Head 2:
Q2 / K2 / V2

Head 3:
Q3 / K3 / V3

...

Head 8:
Q8 / K8 / V8
也就是说:
每个 Query Head 都有自己对应的一组 K/V 表示。
例如 Token A:
Head 1 → K_A1、V_A1
Head 2 → K_A2、V_A2
Head 3 → K_A3、V_A3
...
Head 8 → K_A8、V_A8
Token B 也是:
Head 1 → K_B1、V_B1
Head 2 → K_B2、V_B2
...
所以同一个 Token:
在不同 Attention Head 中,可以拥有不同的 K/V 表示。
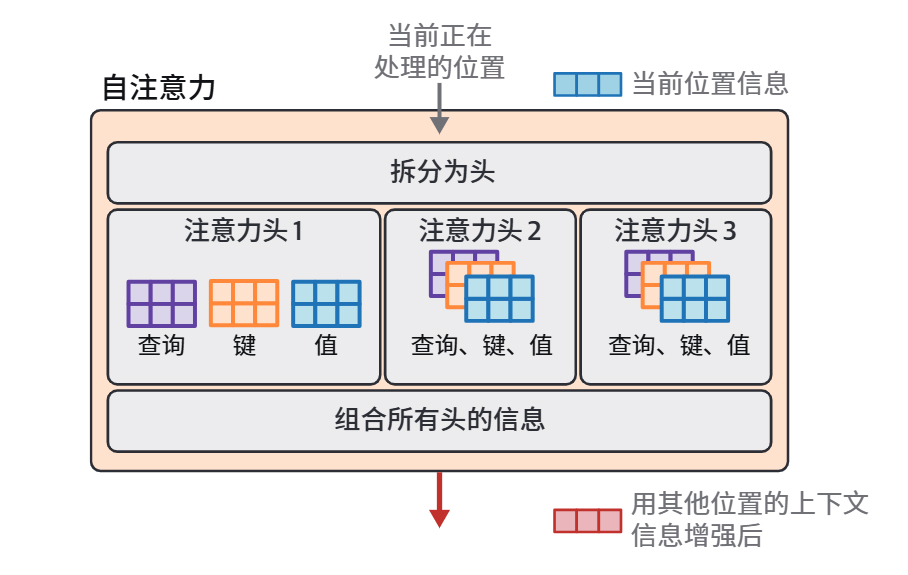
MHA 的优势是:
不同 Head 的 Q/K/V 都可以学习不同的表示方式,表达能力较强。
但问题是:
自回归生成时,每个历史 Token 的每个 KV Head 都需要保存 K/V。
假设:
8 个 KV Head
1000 个历史 Token
那么每一层都需要缓存:
1000 × 8 组 K/V
模型越大、上下文越长,这部分显存和内存带宽压力越明显。
计算流程示例(辅助理解)
MHA:4 个 Token 的计算过程
假设当前有 4 个 Token:
A B C D
并且使用 4 个 Attention Head。
在 MHA 中:
每个 Head 都有自己独立的一套 Q、K、V。
因此,同一个 Token A 在不同 Head 中会有不同的 Q/K/V:
Head 1 → Q_A1、K_A1、V_A1
Head 2 → Q_A2、K_A2、V_A2
Head 3 → Q_A3、K_A3、V_A3
Head 4 → Q_A4、K_A4、V_A4
Token B、C、D 也是一样。
以 Head 1 为例
Head 1 中:
A → Q_A1、K_A1、V_A1
B → Q_B1、K_B1、V_B1
C → Q_C1、K_C1、V_C1
D → Q_D1、K_D1、V_D1
由于是因果注意力,每个 Token 的 Q 只能查询自己和之前 Token 的 K。
注意这里简化写法了,实际上是需要K * Q
Token A:

Q_A1
→ K_A1
→ 加权 V_A1
Token B:

Q_B1
→ K_A1、K_B1
→ 加权 V_A1、V_B1
Token C:

Q_C1
→ K_A1、K_B1、K_C1
→ 加权 V_A1、V_B1、V_C1
其他 Head 也是同样的计算方式
例如 Head 2 中的 Token D:
Q_D2
→ K_A2、K_B2、K_C2、K_D2
→ 加权 V_A2、V_B2、V_C2、V_D2
Head 3:
Q_D3
→ K_A3、K_B3、K_C3、K_D3
→ 加权 V_A3、V_B3、V_C3、V_D3
MQA:Multi-Query Attention
MQA 的思路非常直接:
Query Head 仍然保留多个,但所有 Query Head 共享同一个 KV Head。
例如仍然有 8 个 Query Head:
Q1 ─┐
Q2 ─┤
Q3 ─┤
Q4 ─┤
Q5 ─┤
Q6 ─┤
Q7 ─┤
Q8 ─┘
     ↓
共享同一个 K/V Head
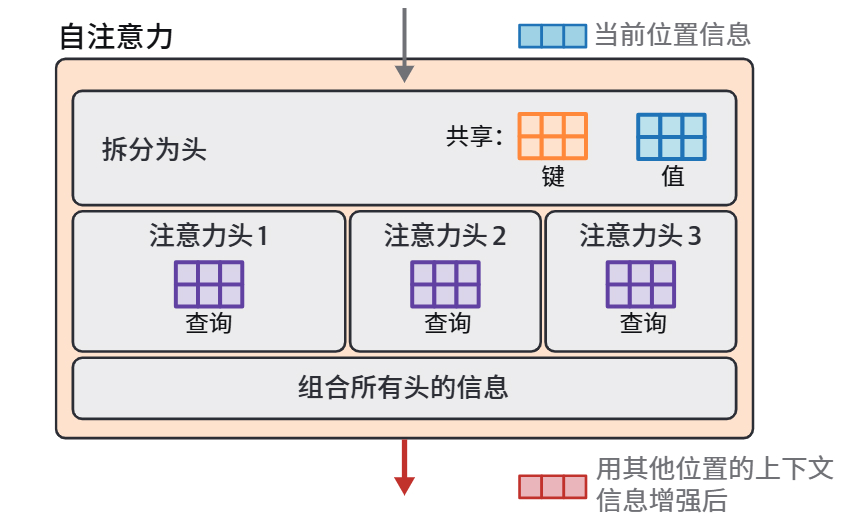
这里最容易误解的是:
“只有一个 K/V”不是说整条序列只有一个 K 和一个 V。
MQA 中每个 Token 仍然有自己的 K/V:
Token A → K_A、V_A
Token B → K_B、V_B
Token C → K_C、V_C
...
区别只是:
MHA:
每个token在不同 Head 下有多套 Q/K/V

MQA:
每个token只有一套的 K/V。
每个token在不同的head里都有一个Q。

(注意在MQA里,只有一套K/V投影矩阵。 并非像MHA那样每个注意力头里都有一套Q/K/V投影矩阵。这也是为什么MQA可以每个token只有一套K/V)
MQA 中不同 Query Head 为什么还能得到不同结果?
MQA 中,所有 Query Head 共享同一套 K/V,但每个 Head 仍然有自己独立的 Q。
假设有 4 个 Token:
A B C D
对于当前 Token D:
Head 1 → Q_D1
Head 2 → Q_D2
Head 3 → Q_D3
Head 4 → Q_D4
但是所有 Head 查询的 K 都是同一套:
K_A
K_B
K_C
K_D
使用的 V 也都是同一套:
V_A
V_B
V_C
V_D
因此 Head 1:
Q_D1
↓
与 K_A、K_B、K_C、K_D 计算相关性
↓
得到一组 Attention 权重
↓
加权 V_A、V_B、V_C、V_D
↓
Head 1 输出
Head 2:
Q_D2
↓
还是与 K_A、K_B、K_C、K_D 计算相关性
↓
得到另一组 Attention 权重
↓
还是加权 V_A、V_B、V_C、V_D
↓
Head 2 输出
虽然两者使用的是同一套 K/V,但是:
Q_D1 ≠ Q_D2
所以:
Q_D1 与 K 的匹配结果
≠
Q_D2 与 K 的匹配结果
最终得到的 Attention 权重也不同。
例如:
Head 1:

Q_D1
→ A 10%
→ B 20%
→ C 60%
→ D 10%
而 Head 2 可能得到:
Head 2:

Q_D2
→ A 40%
→ B 10%
→ C 20%
→ D 30%
虽然它们最后都是读取:
V_A、V_B、V_C、V_D
但是因为权重不同,所以加权后的结果也不同。
因此可以记成:
MQA 是“多个不同的 Q,查询同一套 K/V”。
也就是:
Q_D1 ─┐
Q_D2 ─┤
Q_D3 ─┤→ 同一套 K_A、K_B、K_C、K_D
Q_D4 ─┘
          ↓
       各自得到不同权重
          ↓
       加权同一套 V
          ↓
       得到不同 Head 输出
一句话记忆:
K/V 虽然共享,但每个 Head 提的问题 Q 不一样,所以关注的位置和最终输出仍然可以不同。
计算流程(辅助理解)
如果理解了MHA的计算流程。这里MQA的计算流程很好理解。结合上面刚刚讲过的可以简单理解为:
MQA:4 个 Token 的计算流程
前面已经知道:
MQA 中,每个 Token 在不同 Query Head 中都有自己的 Q,但所有 Query Head 共享同一个 KV Head。
假设当前有 4 个 Token:
A B C D
并且有 4 个 Query Head。
那么:
Token A → Q_A1、Q_A2、Q_A3、Q_A4 + K_A、V_A
Token B → Q_B1、Q_B2、Q_B3、Q_B4 + K_B、V_B
Token C → Q_C1、Q_C2、Q_C3、Q_C4 + K_C、V_C
Token D → Q_D1、Q_D2、Q_D3、Q_D4 + K_D、V_D
其中:
Q
→ 每个 Query Head 都有自己的一份

K/V
→ 每个 Token 只有一份,被所有 Query Head 共享
以 Head 1 为例,其他Head是一样流程
由于是因果注意力:
Token A:

Q_A1
→ K_A
→ 加权 V_A
Token B:

Q_B1
→ K_A、K_B
→ 加权 V_A、V_B
其他 Query Head 使用完全相同的 K/V
例如当前 Token D:
Head 1:
Q_D1 → K_A、K_B、K_C、K_D
     → 加权 V_A、V_B、V_C、V_D

Head 2:
Q_D2 → K_A、K_B、K_C、K_D
     → 加权 V_A、V_B、V_C、V_D
各个 Head 使用的是同一套 K/V,但由于各自的 Q 不同,因此会得到不同的 Attention 权重和输出。具体原因见上一节 “MQA 中不同 Query Head 为什么还能得到不同结果?”。
整个 MQA 可以压缩成:
Head 1:Q1 ─┐
Head 2:Q2 ─┤
Head 3:Q3 ─┤→ 共享同一个 KV Head
Head 4:Q4 ─┘

对于每个 Query:
Q
↓
查询当前因果范围内的共享 K
↓
得到 Attention 权重
↓
加权对应的共享 V
↓
得到该 Head 的输出
MQA 的核心变化并不是 Attention 的计算流程变了,而是 K/V 不再为每个 Query Head 各保存一套,而是所有 Query Head 共用一个 KV Head。
MQA 为什么能显著减少 KV Cache?
自回归生成时,每个历史 Token 的 K/V 都需要保存。
假设模型有:
8 个 Query Head
MHA:
每个 Token
↓
保存 8 组 K/V
MQA:
每个 Token
↓
只保存 1 组 K/V
所以从概念上看:
MHA KV Cache:
Token 数 × 8 个 KV Head

MQA KV Cache:
Token 数 × 1 个 KV Head
这会明显减少:
显存占用
+
读取 KV Cache 的内存带宽
而自回归 Decode 阶段经常受到内存带宽限制,因此 MQA 可以显著提高推理效率。
MQA 的代价
MQA 的问题也很直观。
MHA:
Q1 → K1/V1
Q2 → K2/V2
Q3 → K3/V3
...
每个 Head 都可以拥有自己的 K/V 表示空间。
而 MQA:
Q1 ─┐
Q2 ─┤
Q3 ─┤
... ├→ 同一个 K/V
Q8 ─┘
所有 Query Head 都必须依赖同一套 K/V。
因此:
K/V 的表示多样性下降。
这样虽然更高效,但有可能损失一部分模型表达能力和质量。
于是出现了:
GQA。
GQA:Grouped-Query Attention
GQA 是 MHA 和 MQA 之间的折中方案。
假设:
8 个 Query Head
4 个 KV Head
那么一个token可以分成:
Q1、Q2 → KV1

Q3、Q4 → KV2

Q5、Q6 → KV3

Q7、Q8 → KV4
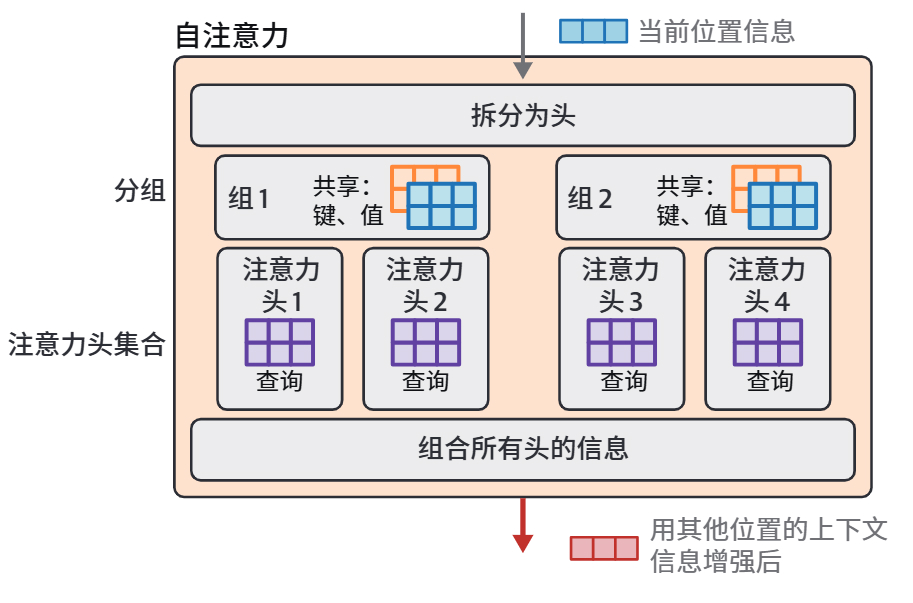
所以:
组内像 MQA:多个 Q Head 共用一个 KV Head。
组与组之间像 MHA:不同组拥有不同的 KV。
例如:
Group 1:
Q1,Q2
   ↓
K1 / V1

Group 2:
Q3,Q4
   ↓
K2 / V2
这样就不像 MQA 那样所有 Query Head 都只能使用同一套 K/V,同时 KV Head 数量又比 MHA 少。
因此:
MHA
表达能力较强
KV Cache 最大

        ↓

GQA
在表达能力与效率之间折中

        ↓

MQA
KV Cache 最小
效率最高
K/V 多样性最低
三者真正改变的是什么?
Attention 的核心计算并没有改变:
Q × Kᵀ
↓
Softmax
↓
Attention Weight
↓
加权 V
↓
Head Output
改变的只是:
每个 Query Head 使用自己的 K/V,还是与其他 Query Head 共享 K/V。
因此:
MHA:
Q1 × K1ᵀ → 加权 V1
Q2 × K2ᵀ → 加权 V2
GQA:
Q1 × K1ᵀ → 加权 V1
Q2 × K1ᵀ → 加权 V1

Q3 × K2ᵀ → 加权 V2
Q4 × K2ᵀ → 加权 V2
MQA:
Q1 × Kᵀ → 加权 V
Q2 × Kᵀ → 加权 V
Q3 × Kᵀ → 加权 V
...
所以三者本质都是:
Q 查 K 得到权重,再按照权重读取 V。
区别只在:
K/V 到底共享到什么程度。
最终总结
Attention 效率优化可以先分成两条路线理解:
路线 1:少看一些 Token

Full Attention
↓
Sparse / Sliding Window Attention

减少 Q-K 之间需要计算的位置数量
路线 2:少保存一些 K/V

MHA
↓
GQA
↓
MQA

减少 KV Head 数量
↓
减少 KV Cache
↓
降低显存和内存带宽压力
因此:
Sparse Attention 优化的是“看多少位置”。
MQA / GQA 优化的是“每个位置需要保存多少套 K/V”。
这两者解决的是不同的问题。
Flash Attention
Flash Attention 是一种广受欢迎的方法和实现,可以显著提升 GPU 上 Transformer LLM 的训练和推理速度。它通过优化 GPU 共享内存(SRAM)和高带宽内存(HBM)之间的数据加载和迁移来加速注意力计算。
补充理解:
FlashAttention 不是一种新的注意力数学机制——它计算的仍然是标准的Softmax (QK^T) V,数学语义不变。它优化的是 GPU 内存访问方式:普通实现会让中间大矩阵在 HBM(容量大、速度相对慢)和片上 SRAM(容量小、速度极快)之间反复读写;FlashAttention 通过分块计算,把一小块 Q/K/V 放进 SRAM 后尽可能完成更多计算,减少中间矩阵写回 HBM 的次数。注意区分:这里的 Shared Memory 是 GPU 芯片内部的高速片上存储,与 Windows 任务管理器中的"共享 GPU 内存"(GPU 借用系统 RAM)完全是两回事。
3.2.2 Transformer 块
前面已经知道,一个 Transformer Block 最核心的两个计算模块是:
Self-Attention
+
FFN(Feed-Forward Network)
但一个完整的 Transformer Block 并不是简单的:
Attention
↓
FFN
在这两个模块外面,还有两个非常重要的结构:
Residual Connection(残差连接)
Normalization(归一化)
因此,理解 Transformer Block 时,可以先抓住四个核心组成:
Self-Attention
FFN
Residual Connection
Normalization
标准 Transformer Block
原始 Transformer 中,一个 Block 可以粗略理解成两个连续的子层:
第一个子层:
[Self-Attention]
+
Residual (残差连接)
+
LayerNorm (归一化)

第二个子层:
[FFN]
+
Residual (残差连接)
+
LayerNorm (归一化)
完整流程大致为:
输入 X
↓
Self-Attention
↓
+ X(残差连接)
↓
LayerNorm(归一化)
↓
得到 Y

Y
↓
FFN
↓
+ Y(残差连接)
↓
LayerNorm (归一化)
↓
得到 Z
也就是:
X
↓
Attention
↓
Residual + Norm (残差连接  +  归一化)
↓
FFN
↓
Residual + Norm (残差连接  +  归一化)
↓
下一个 Transformer Block
原始 Transformer 的结构图:
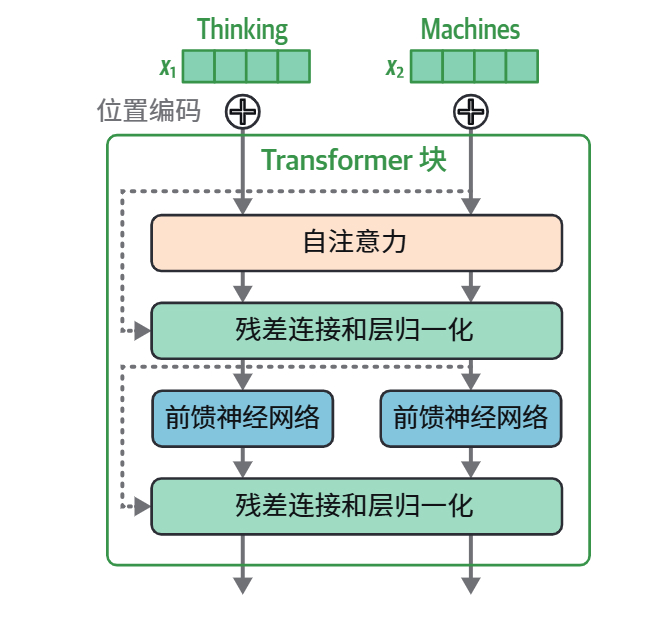
残差连接:旧信息不要直接丢掉
残差连接的基本形式是:
其中:
X:进入当前子层之前的表示F(X):Attention 或 FFN 计算得到的结果Y:二者相加后得到的新表示
例如 Attention 子层:
X
├───────────────┐
│               │
↓               │
Attention       │
↓               │
F(X)            │
│               │
└──────→ + ←────┘
          ↓
          Y
也就是:
原来的 X
+
Attention 得到的新信息
↓
新的表示 Y
可以把它粗略理解成:
Attention 不需要把原来的 Token 表示全部重新写一遍,而是在原表示基础上补充或修改信息。
例如某个 Token 当前表示已经包含:
这个 Token 是什么
+
前几层已经得到的上下文信息
Attention 又得到了一些新的上下文信息。
残差连接不会直接把旧表示扔掉,而是:
旧表示
+
新得到的信息
共同进入后面的网络。
残差不是一直加最初的 Embedding
这里容易误解。
并不是:
每一个 Block
都把最开始的 Token Embedding 加回来
而是:
每个子层保存的是“进入当前子层之前的表示”。
例如:
X⁰
↓
Block 1
↓
X¹ = X⁰ + 更新1

X¹
↓
Block 2
↓
X² = X¹ + 更新2

X²
↓
Block 3
↓
X³ = X² + 更新3
所以它是逐层累积的:
X⁰
→ X¹
→ X²
→ X³
→ ...
不是:
每层都重新回到 X⁰
残差连接为什么有利于训练深层网络?
残差除了帮助保留信息,还有一个非常重要的作用:
给梯度提供更直接的传播路径。
因为:
所以:
这里的:
1
来自那条直接的:
X → Y
残差路径。
可以粗略理解成:
普通路径:

梯度
↓
Attention / FFN
↓
前一层
同时还有:
残差路径:

梯度
────────→
前一层
因此梯度不必全部穿过复杂的子层才能向前传播。
一句话:
Residual 让信息和梯度都拥有一条更直接的通路。
归一化:控制隐藏表示的数值尺度
Transformer 会堆叠很多层。
每一层都会不断进行:
矩阵乘法
Attention
FFN
残差相加
如果完全不控制数值尺度,隐藏表示的大小可能随着网络加深不断漂移。
例如(仅为辅助理解,数值仅为参考):
第 1 层:

[0.2, -0.8, 1.1]
经过很多层以后可能变成:
[10, -30, 50]
甚至:
[200, -700, 1000]
这里的问题并不是:
数值大 = 一定错误
而是:
不同层之间的数值尺度如果变化过于剧烈,会让训练变得更加不稳定。
例如 Attention 中要计算:
如果 Q、K 的尺度过大,Attention Score 也可能变得非常极端。
例如:
[1.0, 1.5, 0.8]
↓
Softmax
↓
权重相对平滑
如果整体尺度扩大很多:
[10, 15, 8]
↓
Softmax
↓
某一个位置可能占据绝大多数权重
这会让 Softmax 更容易进入非常尖锐的区域,并增加训练的不稳定性。
因此 Normalization 的作用可以粗略理解成:
把隐藏表示调整到比较稳定的数值尺度,再继续进行后面的计算。
Norm 不是把所有数值变成一样
Normalization 并不是:
[1, 5, -2, 8]
↓
[1, 1, 1, 1]
而是在保留各个维度之间相对差异的同时:
调整整体中心和 / 或尺度
因此可以记成:
Norm 主要控制数值尺度,而不是抹掉 Token 中的信息。
另外 Transformer 中的 LayerNorm / RMSNorm 通常是:
对每个 Token 自己的隐藏向量内部进行归一化。
例如:
Token A:

[x1, x2, x3, ... xd]
↓
Norm
↓
新的 [x1, x2, x3, ... xd]
并不是把:
Token A
Token B
Token C
混在一起求一个统一的平均值。
原始 Transformer:LayerNorm
原始 Transformer 使用的是:
LayerNorm
其核心过程可以理解成:
计算均值
↓
减去均值
↓
根据方差进行缩放
↓
再使用可学习参数调整
公式为:
其中:
μ
→ 当前隐藏向量的均值

σ²
→ 方差

γ、β
→ 模型训练得到的参数
原始 Transformer 使用 Post-Norm
原始 Transformer 中:
Attention
↓
残差相加
↓
Norm
所以叫:
Post-Norm
因为 Norm 位于子层计算之后。
Attention 子层:
FFN 子层:
整个 Block 可以记成:
X
↓
Attention
↓
+ X
↓
LayerNorm
↓
Y

Y
↓
FFN
↓
+ Y
↓
LayerNorm
↓
Z
现代 Transformer Block
现代 LLM 并没有推翻:
Attention
+
FFN
+
Residual
+
Normalization
这套核心结构。
主要是对其中一些组件和排列方式进行了调整。
例如 Llama 类模型中常见:
Post-Norm
↓
改成
Pre-Norm
LayerNorm
↓
改成
RMSNorm
普通 ReLU FFN
↓
改成
SwiGLU 等门控 FFN
Attention 内部还可能使用:
RoPE
GQA
现代 Transformer 的结构示意图:
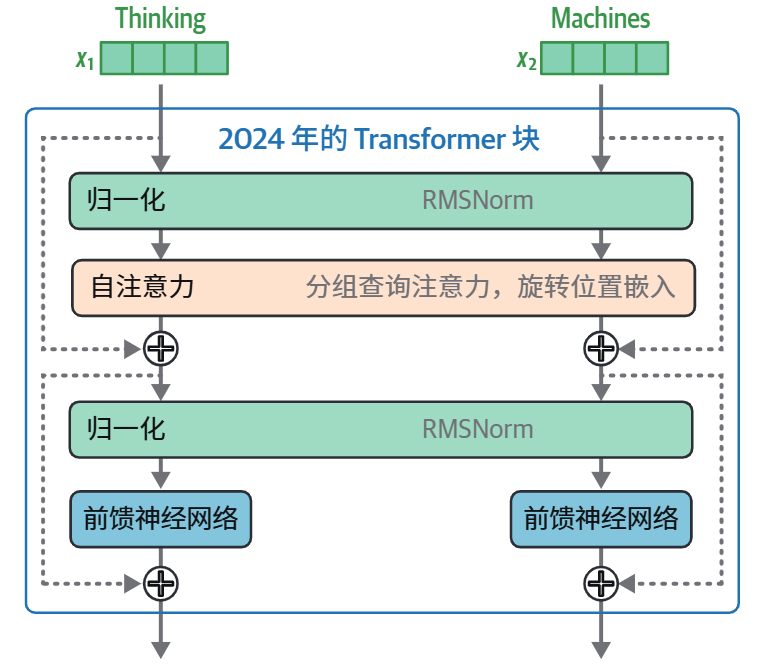
最明显的变化之一就是:
Norm 从 Attention / FFN 后面移动到了前面。
Pre-Norm:先归一化,再进入子层
现代很多 LLM 使用:
Pre-Norm
Attention 部分变成:
X
├─────────────────┐
↓                 │
Norm              │
↓                 │
Attention         │
↓                 │
+ ←───────────────┘
↓
Y
公式:
FFN 部分:
Y
├─────────────────┐
↓                 │
Norm              │
↓                 │
FFN               │
↓                 │
+ ←───────────────┘
↓
Z
公式:
所以一个现代 Pre-Norm Transformer Block 可以记成:
X
↓
Norm (归一)
↓
Attention
↓
+ X (残差)
↓
Y

Y
↓
Norm
↓
FFN
↓
+ Y
↓
Z
和 Post-Norm 对比:
Post-Norm:

X
↓
Attention
↓
+ X
↓
Norm
Pre-Norm:

X
↓
Norm
↓
Attention
↓
+ X
为什么现代模型常使用 Pre-Norm?
Pre-Norm 中,送进 Attention / FFN 的输入先经过归一化:
X
↓
Norm
↓
Attention
因此子层接收到的数值尺度更加稳定。
与此同时,残差主路径:
X ─────────────→ +
可以直接绕过:
Norm
Attention
所以:
信息
+
梯度
都有一条更加直接的主干路径。
可以简单记:
Pre-Norm:子层吃的是稳定的输入,残差主干保持直接。
这也是它在深层 Transformer 中非常常见的重要原因。
RMSNorm:更简单的归一化
现代很多 LLM 不再使用完整 LayerNorm,而是使用:
RMSNorm
LayerNorm:
先减均值
↓
再根据方差缩放
RMSNorm:
不减均值
↓
主要根据均方根进行缩放
可以简单对比:
| LayerNorm | RMSNorm | |
|---|---|---|
| 减均值 | 是 | 否 |
| 控制尺度 | 是 | 是 |
| 可学习缩放 | 有 | 有 |
| 结构 | 相对复杂 | 更简单 |
RMSNorm 可以写成:
其中:
所以可以记:
LayerNorm = 中心化 + 缩放。
RMSNorm = 主要只做缩放。
SwiGLU:现代 FFN 的常见改进
原始 Transformer 的 FFN 使用比较简单的非线性激活,例如 ReLU。
现代很多 LLM 则会使用:
SwiGLU
这是一种带有门控机制的 FFN。
可以粗略理解成:
输入 X
│
├→ 内容分支
│
└→ 门控分支
      ↓
   两者结合
      ↓
     输出
相比简单的:
Linear
↓
ReLU
↓
Linear
SwiGLU 可以更加灵活地控制:
哪些特征应该保留
哪些特征应该削弱
这一阶段暂时记住:
原始 Transformer
→ ReLU FFN

现代很多 LLM
→ SwiGLU 等门控 FFN
即可。
原始 Transformer 与现代 Transformer 对比
可以把主要变化整理成:
| 组件 | 原始 Transformer | 现代很多 LLM |
|---|---|---|
| Attention | MHA | MHA / GQA / MQA |
| Norm | LayerNorm | RMSNorm 常见 |
| Norm 位置 | Post-Norm | Pre-Norm 常见 |
| FFN 激活 | ReLU | SwiGLU 常见 |
| Position | 绝对位置编码 | RoPE 常见 |
但无论怎么改,最核心的 Block 仍然没有发生根本变化:
Attention + FFN + Residual + Normalization
Transformer Block 最终理解
标准 Transformer:
X
↓
Attention
↓
Residual
↓
Norm
↓
FFN
↓
Residual
↓
Norm
现代很多 Decoder-only LLM:
X
↓
Norm
↓
Attention
↓
Residual
↓
Norm
↓
FFN / SwiGLU
↓
Residual
所以这一节最重要的是记住四个组件分别负责什么:
Attention
→ 整合上下文信息

FFN
→ 进一步变换每个 Token 的表示

Residual
→ 保留旧表示,并提供直接的信息与梯度通路

Normalization
→ 控制数值尺度,提高训练稳定性
一句话总结:
Attention 负责“看上下文”,FFN 负责“进一步加工”,Residual 负责“旧信息别丢、梯度能直通”,Norm 负责“数值别乱跑”。
3.2.3 位置嵌入:RoPE
Self-Attention 可以根据 Q 和 K 判断不同 Token 之间的相关性,但仅靠内容本身,还无法完整表示:
谁在前
谁在后
相隔多远
例如:
我 爱 你
你 爱 我
Token 基本相同,但顺序变化后,含义完全不同。
因此 Transformer 需要额外加入位置信息。
传统位置编码:绝对位置
原始 Transformer 使用绝对位置编码(Absolute Positional Encoding)。
简单理解:
Token 0 → Position 0
Token 1 → Position 1
Token 2 → Position 2
...
位置编码会和 Token Embedding 结合:
Token Embedding
+
Position Encoding
↓
带位置信息的 Token 表示
↓
Transformer
因此同一个 Token:
苹果
如果分别出现在:
位置 3
位置 50
Token Embedding 本身相同,但加入的位置编码不同,所以进入 Transformer 的表示也不同。
传统绝对位置编码通常在进入 Transformer Block 之前,就已经把位置信息加入 Token 的表示中。
Packing
训练大模型时,一篇文档往往远短于模型的 Context Window。
例如:
Context Window = 4096 Token
但某篇文档可能只有:
200 Token
如果一个短文档单独占据整个训练序列,就会浪费大量空间。
因此训练时常使用 Packing(打包):
Document A
+
Document B
+
Document C
+
...
把多个短文档放进同一个训练序列。
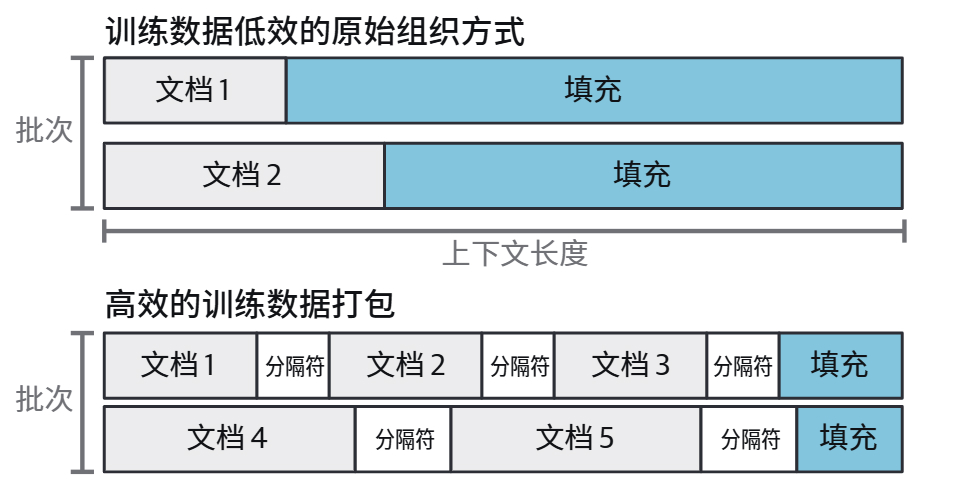
例如一句:
今天 天气 很好
某次可能位于:
500 501 502
另一次可能因为 Packing 位于:
2800 2801 2802
它们的绝对位置变化很大,但内部关系仍然是:
今天 → 天气 → 很好
   1       1
也就是说,语言中很多关系更关心:
两个 Token 之间相隔多远,也就是相对位置。
Packing 是一个帮助理解位置信息重要性的一个例子。
RoPE:把位置信息加入 Q 和 K
RoPE(Rotary Position Embedding,旋转位置编码)采用了不同的方法。
传统位置编码大致是:
Token Embedding
+
Position Encoding
↓
Transformer
而 RoPE 是在 Attention 内部处理位置:
Token 表示 X
↓
计算 Q、K、V
↓
根据位置旋转 Q、K
↓
计算 QKᵀ
↓
Attention
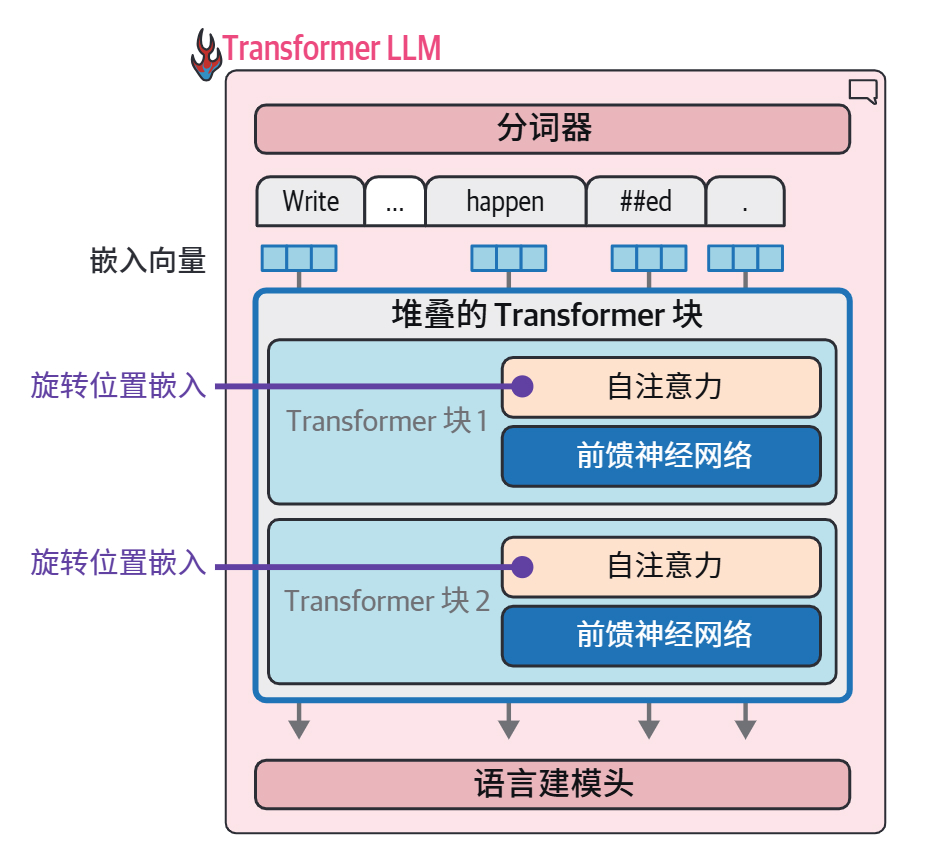
更具体地说:
X
↓
W_Q / W_K
↓
得到原始 Q、K
↓
RoPE 根据 Token 的位置旋转 Q、K
↓
得到带位置信息的 Q、K
↓
QKᵀ
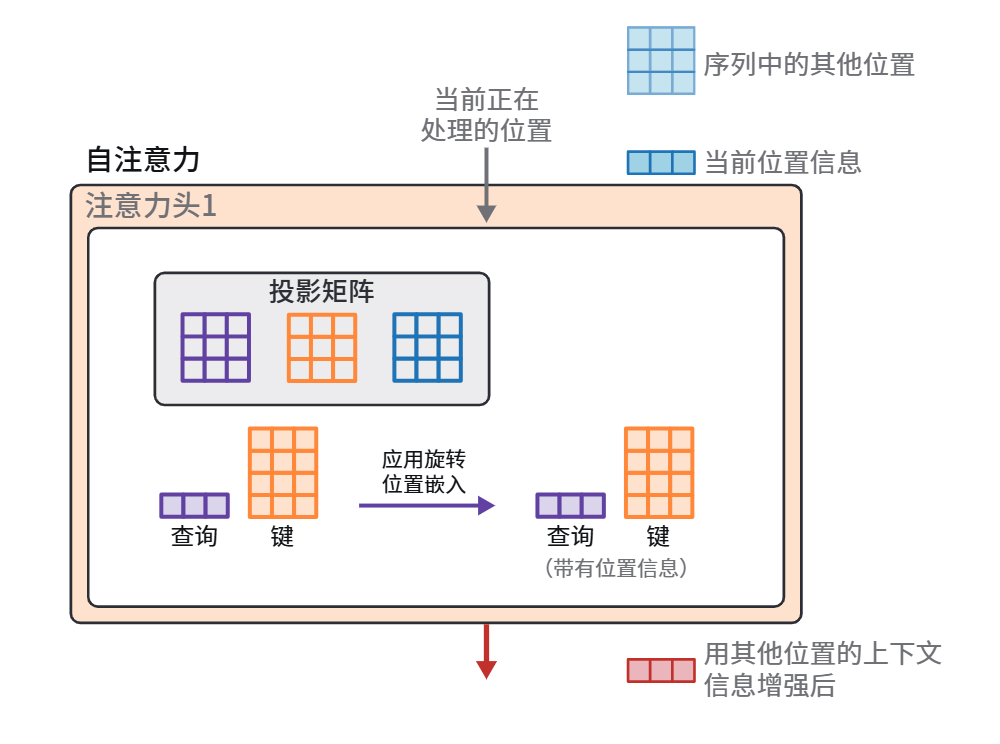
通常:
Q → 使用 RoPE
K → 使用 RoPE
V → 不旋转
因此:
RoPE 并不是额外把一个位置向量加到 Token Embedding 上,而是直接根据位置改变 Q 和 K。
RoPE 到底怎么旋转?
假设某个 Token 在某一个 Attention Head 中产生了一个 8 维 Q:
Q = [q1,q2,q3,q4,q5,q6,q7,q8]
注意:
整个
[q1...q8]才是一个 Q,q1、q2...只是这个 Q 的不同维度。
RoPE 会把这些维度两两配对:
(q1,q2)
(q3,q4)
(q5,q6)
(q7,q8)
为什么要两两配对?
因为 RoPE 使用的是二维旋转。
例如:
(q1,q2)
可以看成一个二维坐标:
x = q1
y = q2
这样就可以像二维平面中的箭头一样进行旋转。
因此:
8维 Q

[q1,q2,q3,q4,q5,q6,q7,q8]

↓

拆成 4 个二维坐标组

(q1,q2)
(q3,q4)
(q5,q6)
(q7,q8)

↓

分别旋转

↓

重新组成一个 8 维 Q
所以 RoPE 并没有把一个 Q 变成多个 Q,只是在同一个 Q 内部对维度进行分组旋转。
每一组旋转多少?
不同二维组会使用不同的固定旋转频率。
例如可以把它想象成:
(q1,q2) → θ1
(q3,q4) → θ2
(q5,q6) → θ3
(q7,q8) → θ4
这些频率:
θ1、θ2、θ3、θ4
不是 Token 自己决定的,也不是 Attention 临时算出来的,而是 RoPE 根据固定公式预先规定好的。
不同组的频率不同,可以理解成几个转速不同的时钟:
第1组 → 转得快
第2组 → 慢一些
第3组 → 更慢
第4组 → 更慢
然后 Token 的位置决定最终转多少。
假设某个 Token 在:
Position = p
那么:
第1组 → pθ1
第2组 → pθ2
第3组 → pθ3
第4组 → pθ4
因此可以记成:
维度组决定旋转频率,Token 的位置决定实际旋转角度。
例如为了方便理解,假设:
第1组每个位置转 30°
第2组每个位置转 10°
如果 Token 在位置 5:
第1组 → 5 × 30° = 150°
第2组 → 5 × 10° = 50°
真实 RoPE 并不是使用这种简单的 30°、10°,这里只是帮助理解工作方式。
不同 Token 的 Q/K 本来就不同,RoPE 怎么表示位置?
不同 Token 的 Q/K 本来就会不同。
例如:
苹果
香蕉
经过模型计算:
Q苹果 ≠ Q香蕉
K苹果 ≠ K香蕉
因为原始 Q/K 来自:
XW_Q
XW_K
而不同 Token 的当前表示 X 通常不同。
所以可以理解成:
原始 Q/K
→ 主要包含内容和上下文信息
RoPE
→ 根据位置对 Q/K 进行旋转
RoPE 并不是要把内容信息替换成位置信息,而是在原有 Q/K 上加入位置影响。
为什么旋转以后能体现相对位置?
这是 RoPE 最关键的地方。
假设:
Token A 在位置 2
Token B 在位置 5
只看其中一个二维组,并假设这组的旋转频率是 θ。
那么:
Q_A → 旋转 2θ
K_B → 旋转 5θ
Attention 接下来计算:
Q_A · K_B
由于两者分别旋转了:
2θ
5θ
它们之间的相对旋转关系就是:
5θ - 2θ
=
3θ
而:
5 - 2 = 3
正好就是两个 Token 的相对位置差。
因此:
Token A:位置 2
Token B:位置 5
↓
Q_A:旋转 2θ
K_B:旋转 5θ
↓
两者相对旋转 3θ
↓
位置差 3 影响 QK 点积
↓
影响 Attention Score
所以 RoPE 并不会额外产生一个:
距离 = 3
然后交给 Attention。
而是:
通过 Q/K 的旋转,让相对位置直接影响 QK 点积。
数学上可以写成:
其中:
m → Q 所在位置
n → K 所在位置
最终出现的是:
n - m
也就是相对位置。
不需要现在记住公式,只需要理解它表达的意思:
Q 和 K 各自按照自己的位置旋转,做点积时,两次旋转之间的差自然对应两个 Token 的位置差。
为什么需要不同旋转频率?
如果所有二维组都以完全相同的速度旋转:
θ
θ
θ
θ
能够表达的位置模式比较单一。
所以不同维度组使用:
θ1
θ2
θ3
θ4
...
不同频率。
可以把它想象成多个不同速度的钟:
快钟
中速钟
慢钟
更慢的钟
同一个 Position 会在这些“钟”上形成不同的状态。
这样组合起来,就可以表示更丰富的位置关系和不同尺度的距离变化。
RoPE 总结
整个过程可以压缩成:
Token 当前表示
↓
产生 Q、K
↓
Q/K 内部维度两两分组
↓
每组有不同的固定旋转频率
↓
根据 Token 所在位置进行旋转
↓
Q 与 K 做点积
↓
相对旋转关系与位置差有关
↓
Attention Score 自然带上相对位置信息
RoPE 的核心:原始 Q/K 表示内容和上下文;RoPE 再根据 Token 的位置旋转 Q/K,使 QK 点积同时受到内容关系和相对位置关系的影响。
3.2.4 其他架构实验和改进
Transformer 的核心架构已经存在多年,但围绕它仍然有大量研究和工程优化。
这些改进通常并不是完全推翻 Transformer,而是在:
Attention
FFN
Normalization
Position Encoding
模型容量
训练和推理实现
这些部分进行优化。
常见方向可以粗略分成:
Attention 效率
→ Sparse Attention
→ MQA / GQA
→ FlashAttention
位置编码
→ RoPE
→ 长上下文位置扩展方法
Normalization
→ Pre-Norm
→ RMSNorm
FFN
→ SwiGLU
→ 其他门控 FFN
模型容量
→ MoE(Mixture of Experts)
其中有些改进:
改变模型架构
例如:
GQA
RMSNorm
SwiGLU
RoPE
MoE
而有些优化主要改变的是:
同一个数学过程如何更高效地执行
例如:
FlashAttention
它并没有改变 Attention:
QKᵀ
↓
Softmax
↓
加权 V
的基本含义,而是通过优化 GPU 上的数据读取和计算方式,提高执行效率。
Transformer 已经不只用于语言模型
Transformer 最初主要用于自然语言处理,但后来逐渐扩展到很多其他领域,例如:
计算机视觉
语音
多模态
时间序列
机器人
生物信息
不同领域会根据自己的数据特点,对:
输入表示
Attention Pattern
位置编码
模型结构
进行相应调整。
但核心思想仍然非常相似:
让模型通过 Attention 建立不同位置或不同元素之间的关系。
这一部分可以怎么理解?
从原始 Transformer 到现代 LLM,核心框架并没有完全改变:
Attention
+
FFN
+
Residual
+
Normalization
真正不断变化的是:
Attention 怎么更省
位置怎么编码得更好
Norm 怎么更稳定
FFN 怎么更强
模型容量怎么继续扩大
GPU 怎么执行得更快
所以现代 LLM 可以理解成:
在 Transformer 核心框架上不断替换和优化各个组件,而不是完全重新发明一种网络。
本节总结
到这里,现代 Transformer 中几个常见改进可以对应到不同位置:
Sparse Attention
→ 减少需要直接参与 Attention 的 Token
MQA / GQA
→ 减少 KV Head 数量,降低 KV Cache 和带宽压力
FlashAttention
→ 优化 Attention 在 GPU 上的执行方式
Pre-Norm / RMSNorm
→ 提高深层网络训练稳定性
SwiGLU
→ 改进 FFN
RoPE
→ 把位置信息注入 Q/K
MoE
→ 在控制单次计算量的同时扩大模型容量
Transformer 的核心没有被抛弃,现代 LLM 的很多进步都来自对 Transformer 各个组件的持续优化。